Dawn's Blogs

分享技术 记录成长

0%

海象运算符

从 Python 3.8 开始,加入了海象运算符 :=,语法格式是 variable_name := expression。

用法

用于 if-else 条件表达式中

1
2
if a := 5 > 1:
print("do sth")

用于 while 循环

1
2
3
4
5
6
7
8
9
10
# 常规写法
n = 3
while n:
    print('do sth!')
    n -= 1

# 升级写法
n = 3
while (n := n - 1) + 1: 
    print('do sth!')

加 1 是因为在循环条件判断之前,n 已经减 1 了。

读取文件

1
2
3
fp = open("test.txt", "r")
while line := fp.readline():
    print(line)
阅读全文 »

装饰器

装饰器(Decorators),是 Python 中修改其他函数的功能的函数,有助于让我们的代码更简短。

比如可以用一个简易的装饰器,定义一个函数执行之前或者执行之后做的额外工作:

1
2
3
4
5
6
7
8
9
10
11
# 这是一个装饰器
def a_new_decorator(a_func):

def wrapTheFunction():
print("I am doing some boring work before executing a_func()")

a_func()

print("I am doing some boring work after executing a_func()")

return wrapTheFunction

当一个函数需要这个装饰器时,可以这样调用:

1
2
3
4
5
6
7
8
9
10
def a_function_requiring_decoration():
print("I am the function which needs some decoration to remove my foul smell")

a_function_requiring_decoration = a_new_decorator(a_function_requiring_decoration)
#now a_function_requiring_decoration is wrapped by wrapTheFunction()

a_function_requiring_decoration()
#outputs:I am doing some boring work before executing a_func()
# I am the function which needs some decoration to remove my foul smell
# I am doing some boring work after executing a_func()

@ 符号

以上就是一个手动实现的装饰器,可以用 @ 符号来更简单的实现。事实上,@a_new_decorator 就是以下语句的简易声明:

a_function_requiring_decoration = a_new_decorator(a_function_requiring_decoration)

1
2
3
4
5
6
7
8
@a_new_decorator
def a_function_requiring_decoration():
print("I am the function which needs some decoration to remove my foul smell")

a_function_requiring_decoration()
#outputs: I am doing some boring work before executing a_func()
# I am the function which needs some decoration to remove my foul smell
# I am doing some boring work after executing a_func()

但是,运行如下代码会存在一个问题:

1
2
print(a_function_requiring_decoration.__name__)
# Output: wrapTheFunction

因为函数 a_function_requiring_decoration 被重写了,所以这个函数被 warpTheFunction 替代了,这里就需要 functools.wraps。

functools.wraps

修改修饰器的声明方式即可解决上述问题:

1
2
3
4
5
6
7
8
9
from functools import wraps

def a_new_decorator(a_func):
@wraps(a_func)
def wrapTheFunction():
print("I am doing some boring work before executing a_func()")
a_func()
print("I am doing some boring work after executing a_func()")
return wrapTheFunction
阅读全文 »

CNN

对于图片而言,通常使用 CNN(卷积神经网络)。

简化全连接神经网络

若使用全连接神经网络,则参数很多,容易过拟合。

对于图片检测而言,也行不需要看整张图片,只需要看到图片的一部分(所以提出 Receptive Field),就可以检测 pattern。CNN 的简化方式就是一个 Receptive Field 对应于一个神经网络单元。典型的 Receptive Field 设置如下:
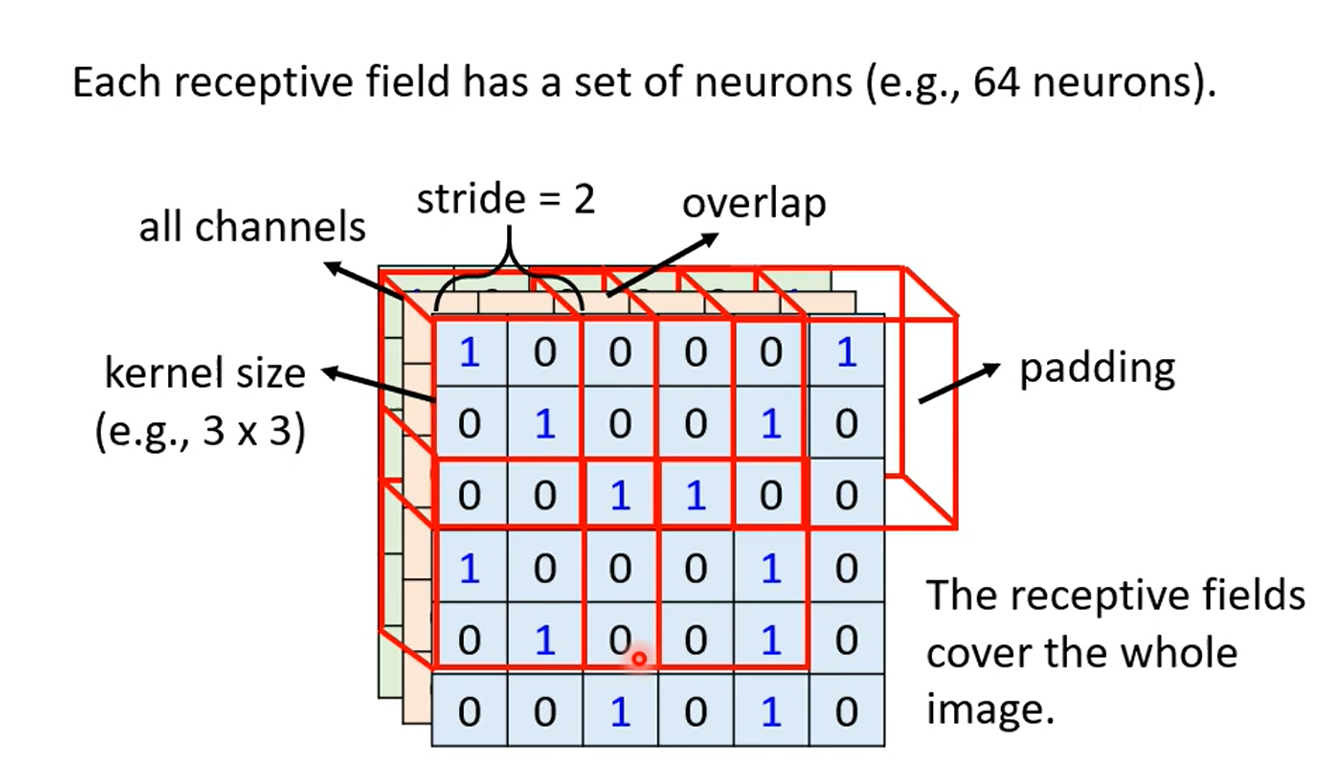
  • 一个 Receptive Field 包含了图片的所有 channel(深度),长度 × 宽度被称为 kernel size。
  • Receptive Field 移动的距离称为步长(stride)。
  • 若 Receptive Field 超出了图片的范围,需要填充(padding)。

1657158365832

共享参数

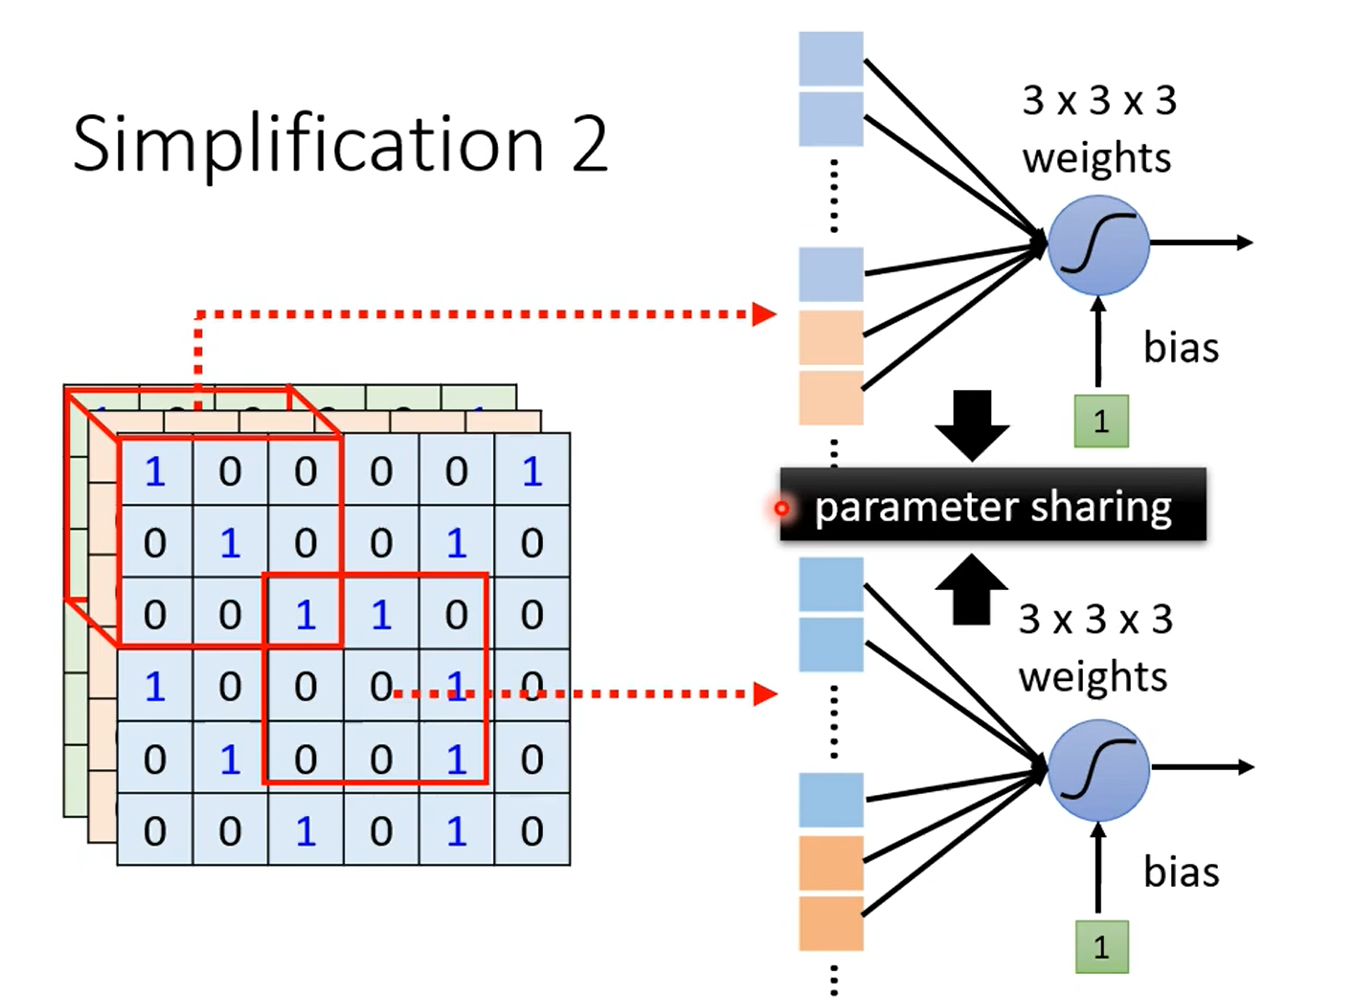
对于图像识别而言,同一个 pattern 的位置可能不同,Receptive Field 用于检测 pattern。

所以对于不同位置的 Receptive Field,可以共享参数(因为尽管这些 Receptive Field 在不同位置,但是它们在检测同一个 pattern)。
1657158755492

Convolutional Layer

Respective Field + 参数共享 = Convolutional Layer(卷积层)。

卷积层中含有很多 filter(一个 filter 相当于一个 Respective Field,filter 中的参数相当于 Respective Field 送入神经网络单元的权重/参数)。

卷积层产生的输出称之为 Feature Map,这可以看作是一个新的图片,图片的 channel 等于 filter 的个数。

池化

池化(Pooling)相当于缩小图片,在人类看来缩小图片,不会影响到 pattern 的检测。

如,Max Pooling:将图片分成多块,提取出每个块中最大的值。

组合起来

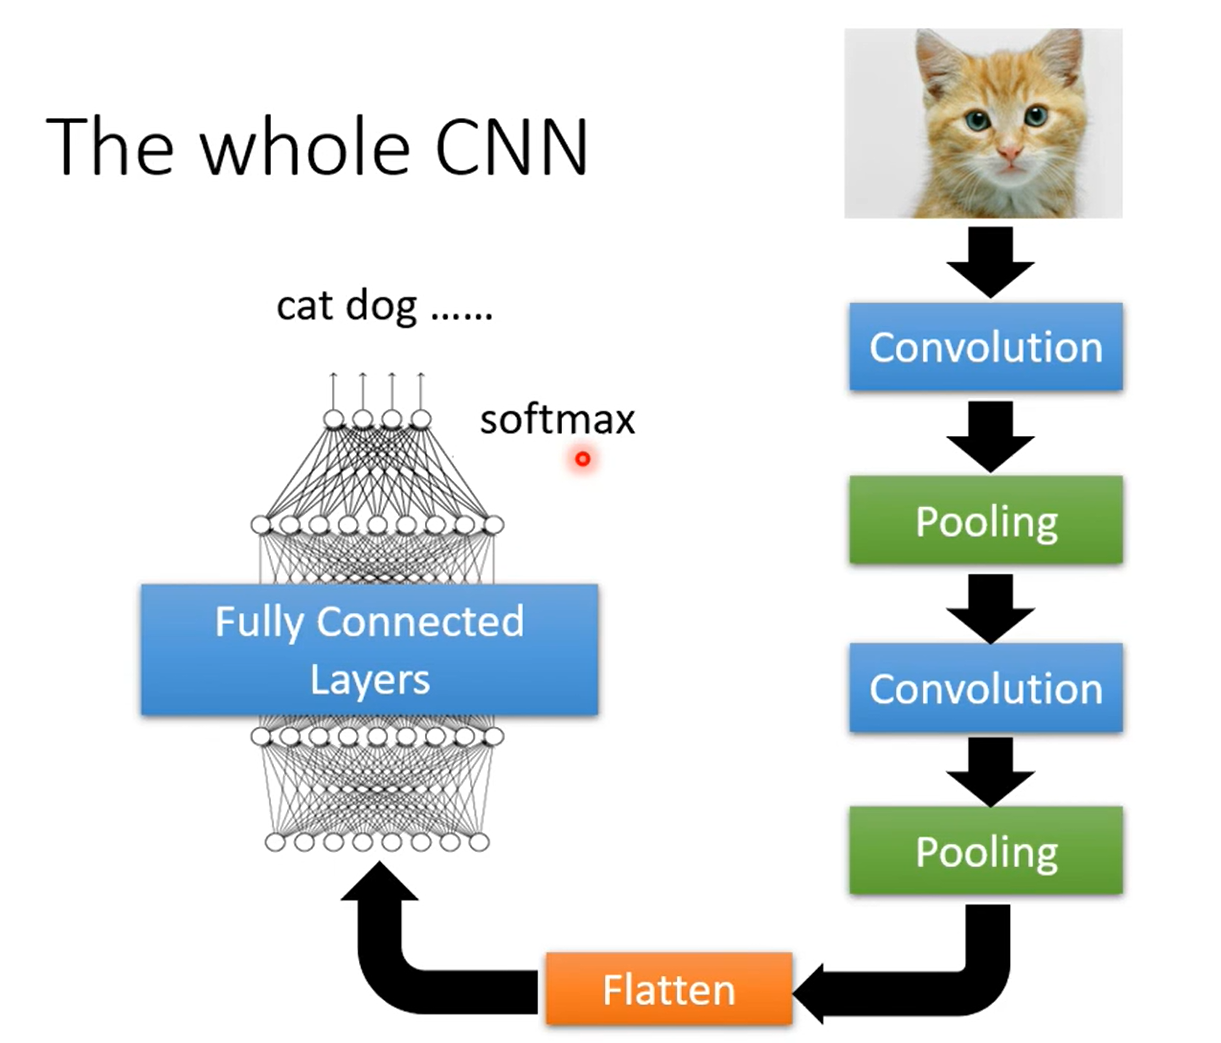
在卷积和池化之后,将得到的结果(相比于原始图片小了很多)送入全连接神经网络,就得到了完整的 CNN 网络。
1657160205164

RNN

基本结构

RNN 中,会将上一次输入的产生的东西保存下来,作为本次的一个输入。

分为 Elman Network 和 Jordan Network:
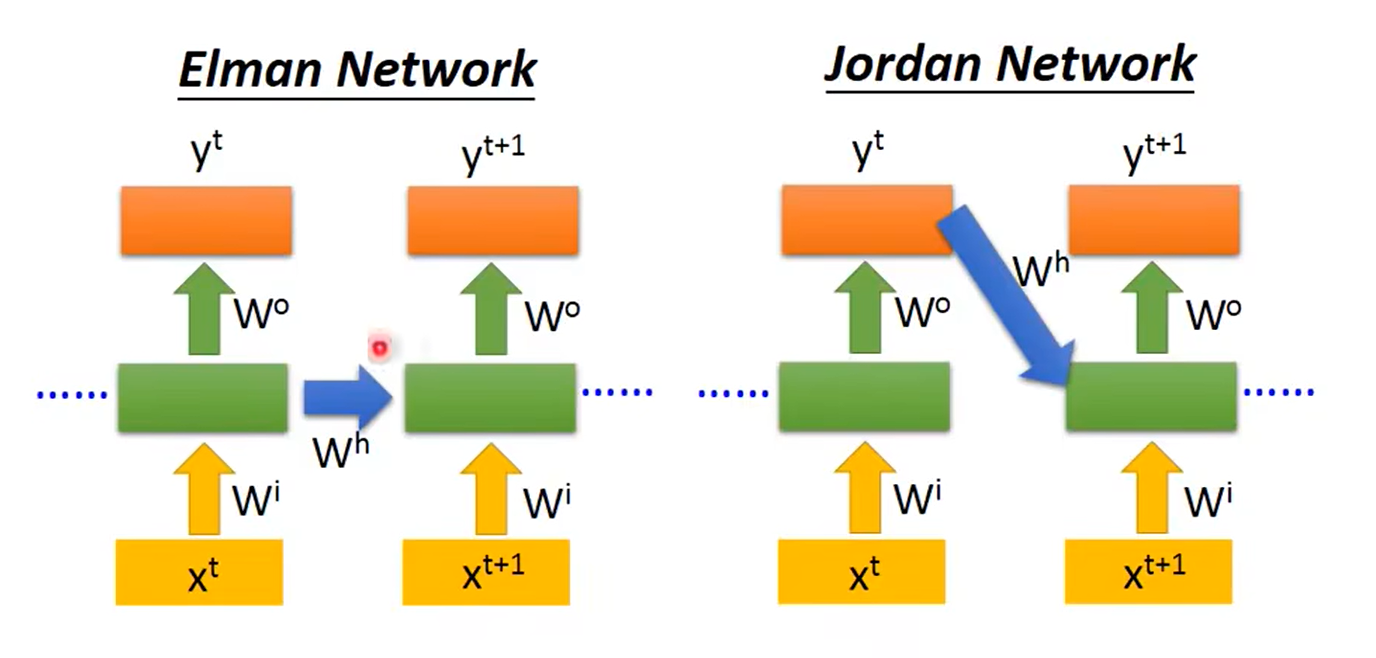
  • Elman Network:保存的是 hiden layer 的值。
  • Jordan Network:保存的是 output 的值。

1657161992754

双向 RNN

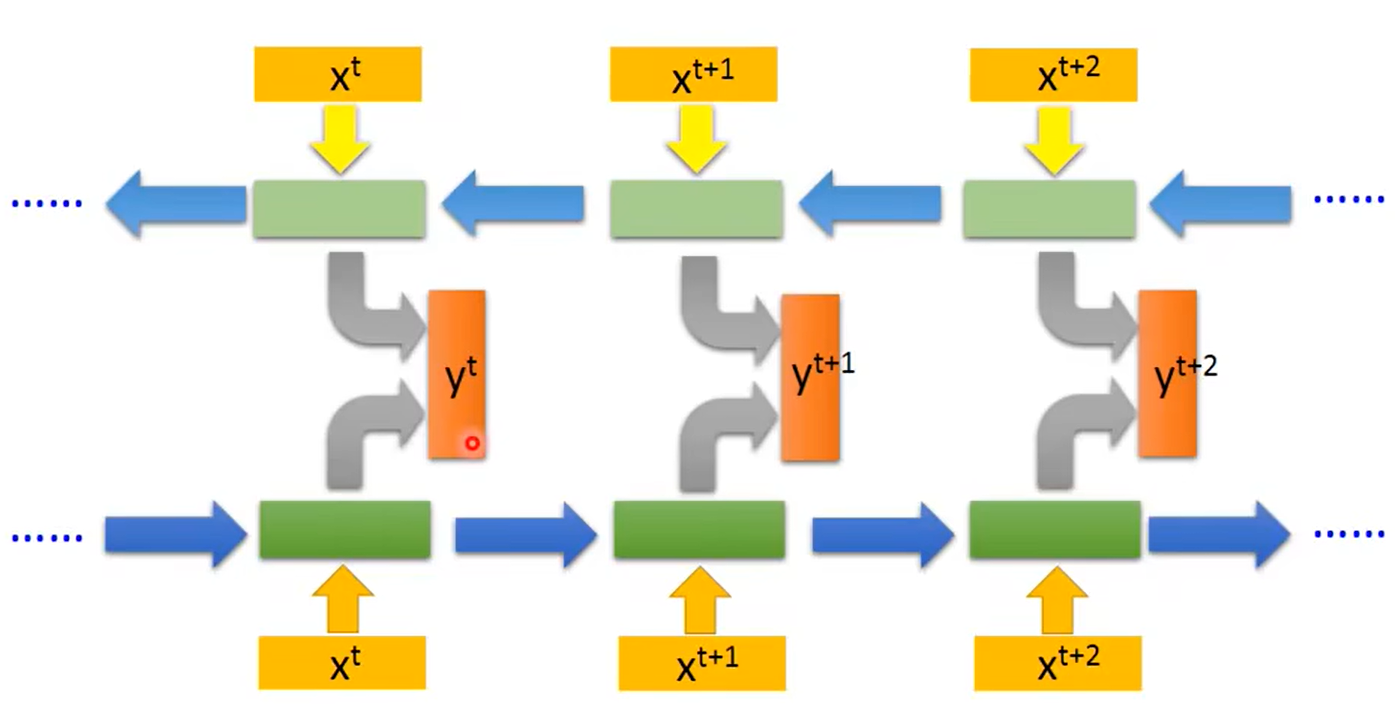
RNN 可以是双向的,训练一个正向 RNN 和一个逆向 RNN,将正向和逆向的输出合并起来进行输出。
1657162262353

LSTM

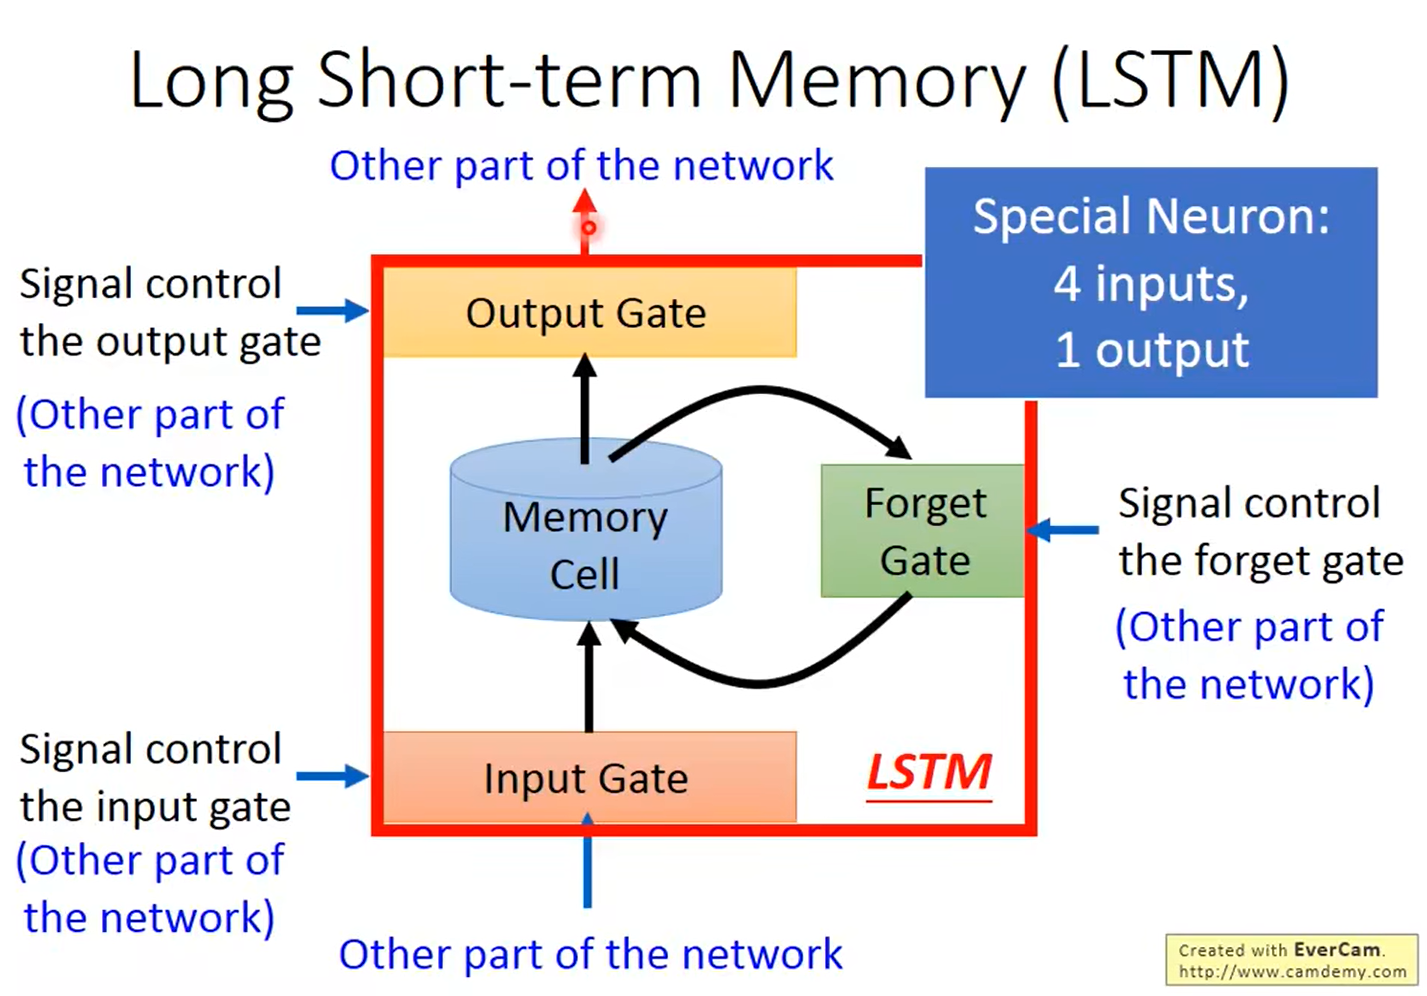
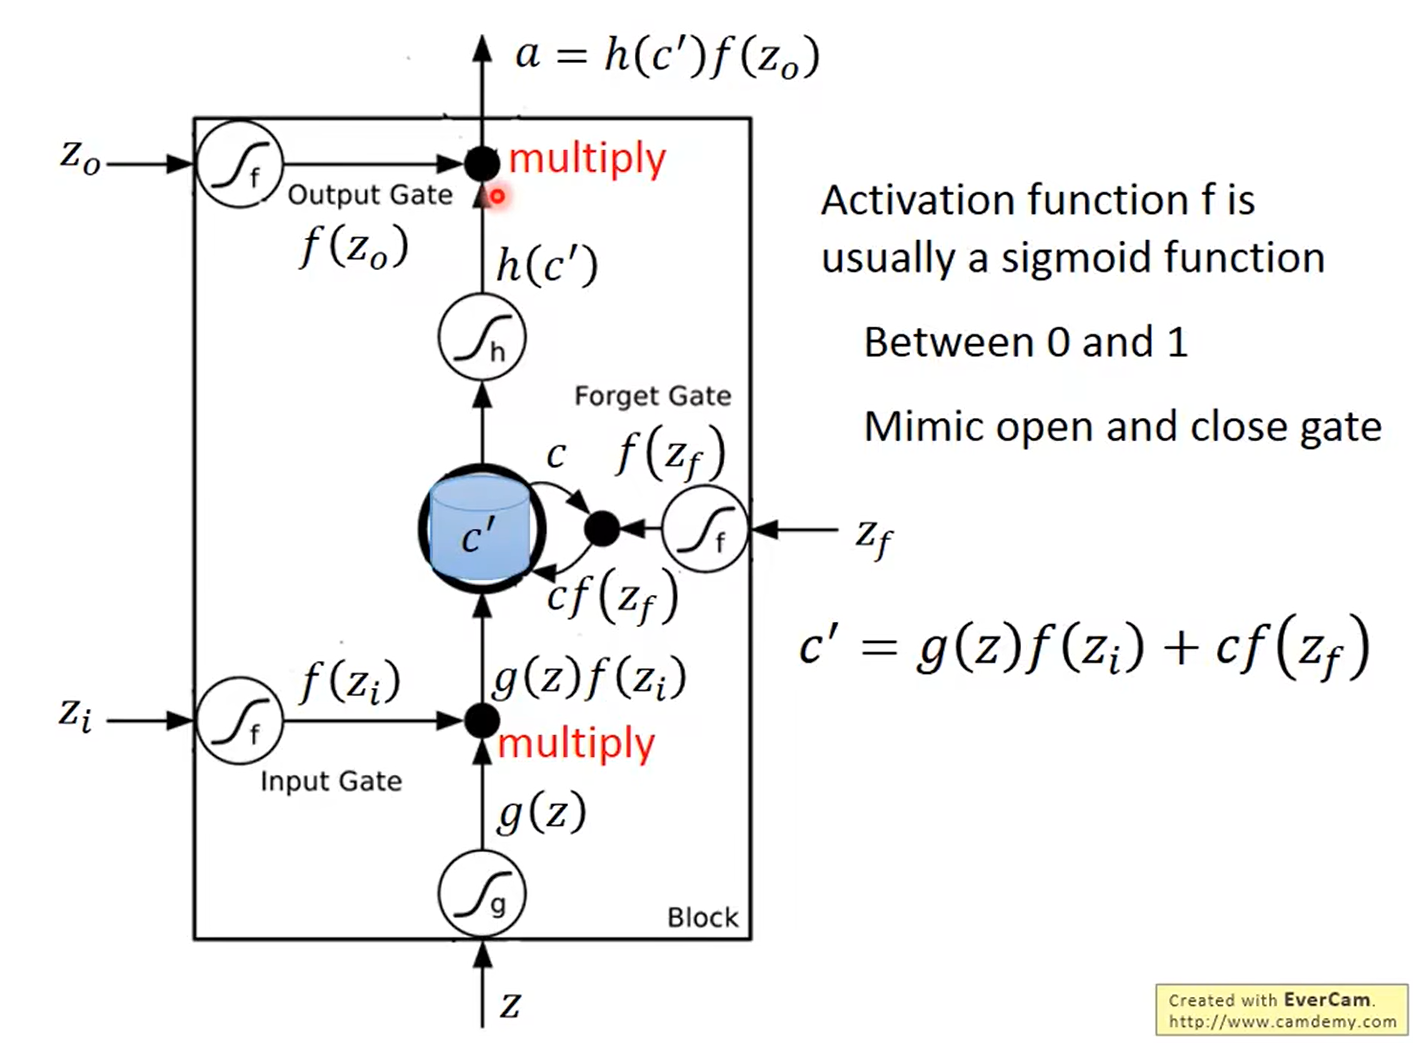
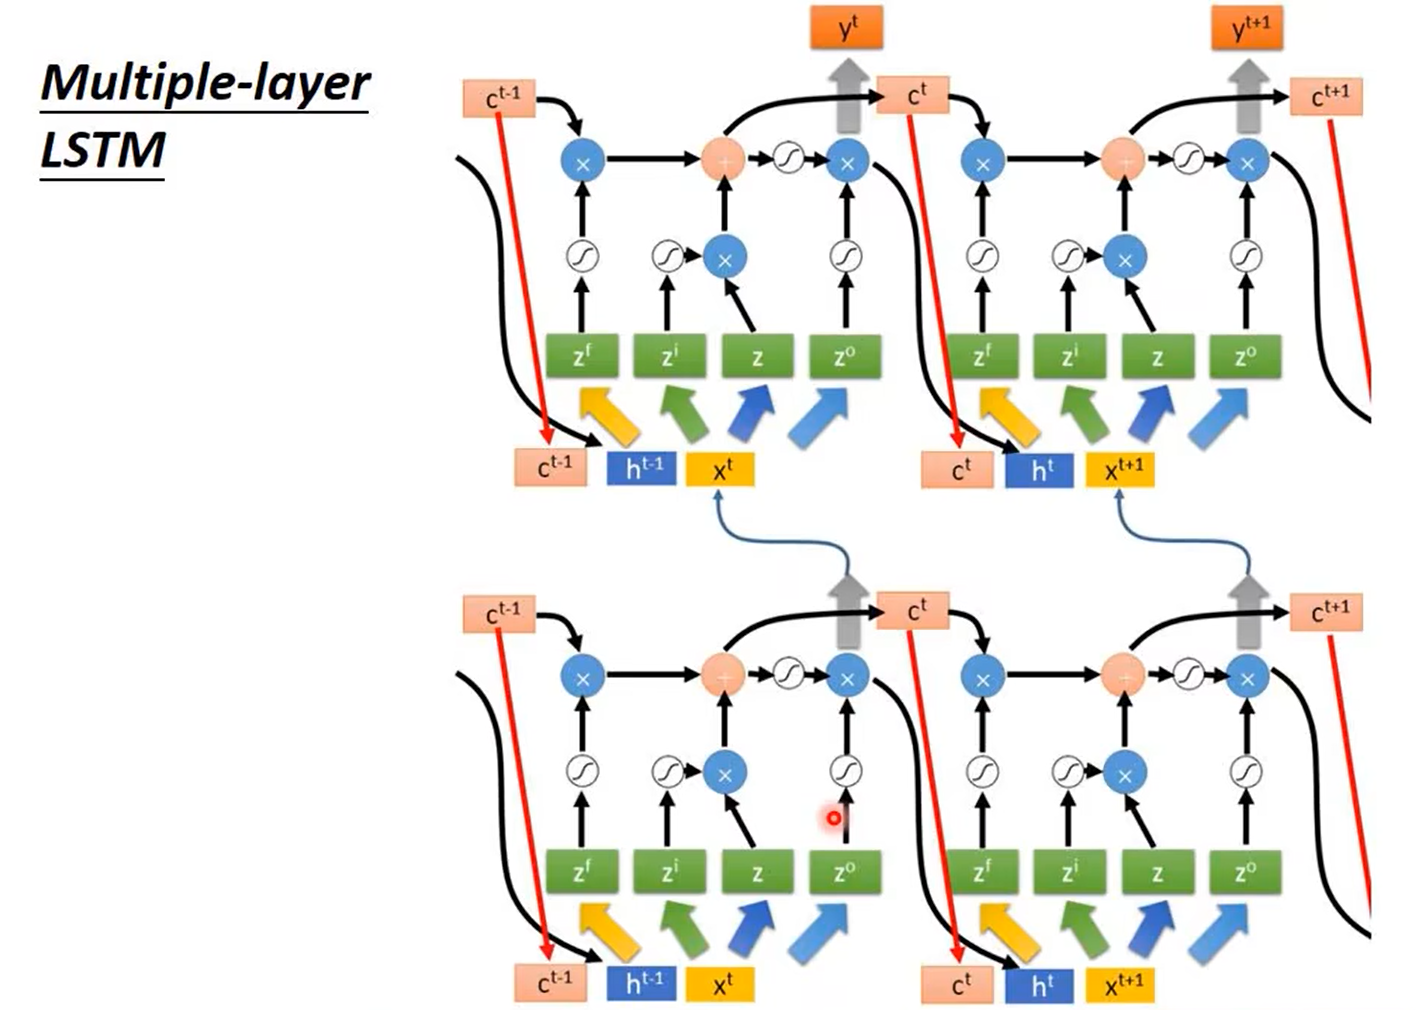
LSTM(Long Short-term Memory)

1657162786833

1657163055876

1657164185170

Constituency Parsing

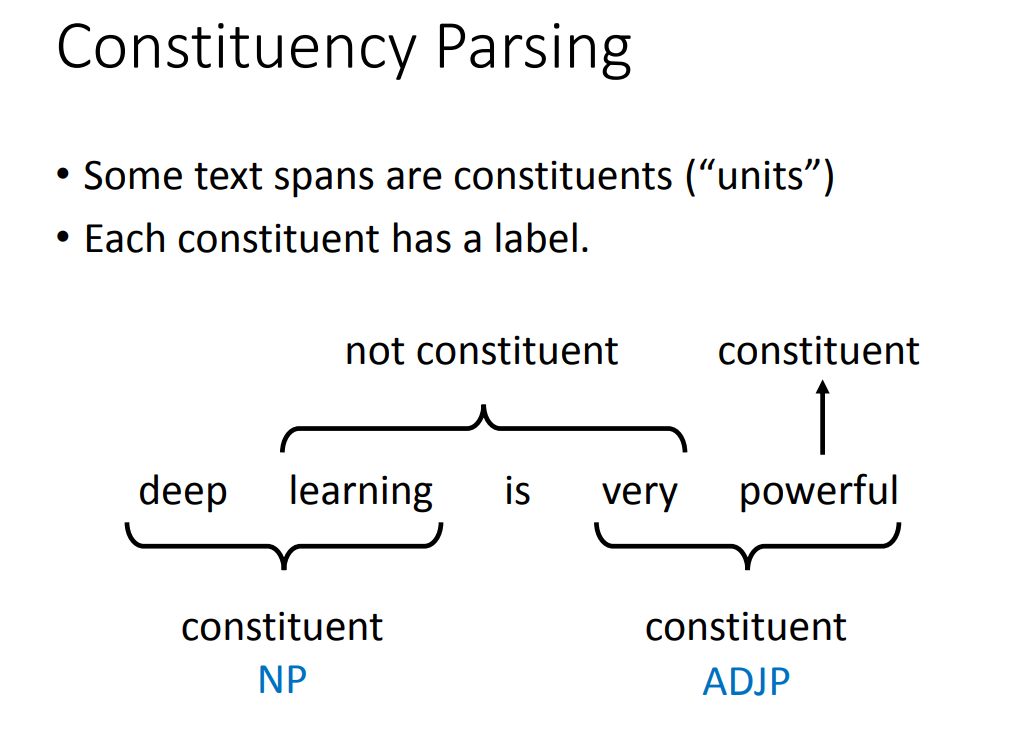
Constituency Parsing 就是:

  • 找出一段 text span 作为 constituents

  • 每一个 constituents 都有一个标签

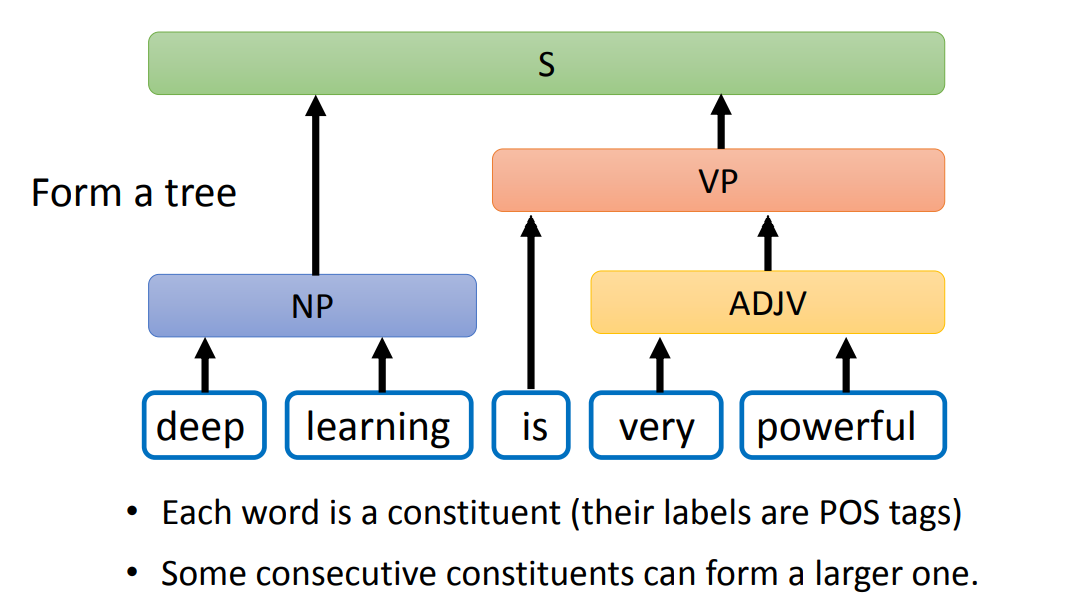
1655892270551

  • 对于每一个单词都是一个 constituent(标签为这个单词的词性)
  • 相邻的 constituent 可以组成一个更大的 constituent
  • 一句话的所有单词,从底向上,可以组成一棵树

1655892544642

Chart-based

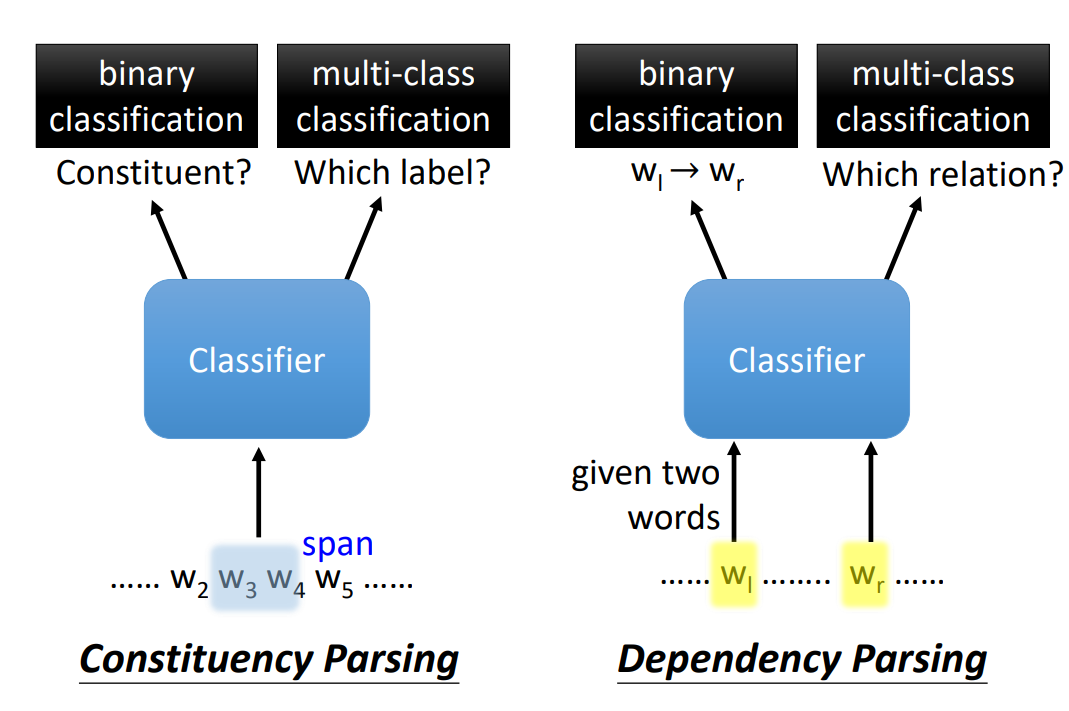
Chart-based 方法实际上就是对每一个 span 进行两次分类:

  • 放入二分类:判断是否是 constituent
  • 放入多分类:constituent 属于哪一个标签

下图是 Chart-based 的结构,其中 Span Feature Extraction 与 Coreference Resolution 中的一样。
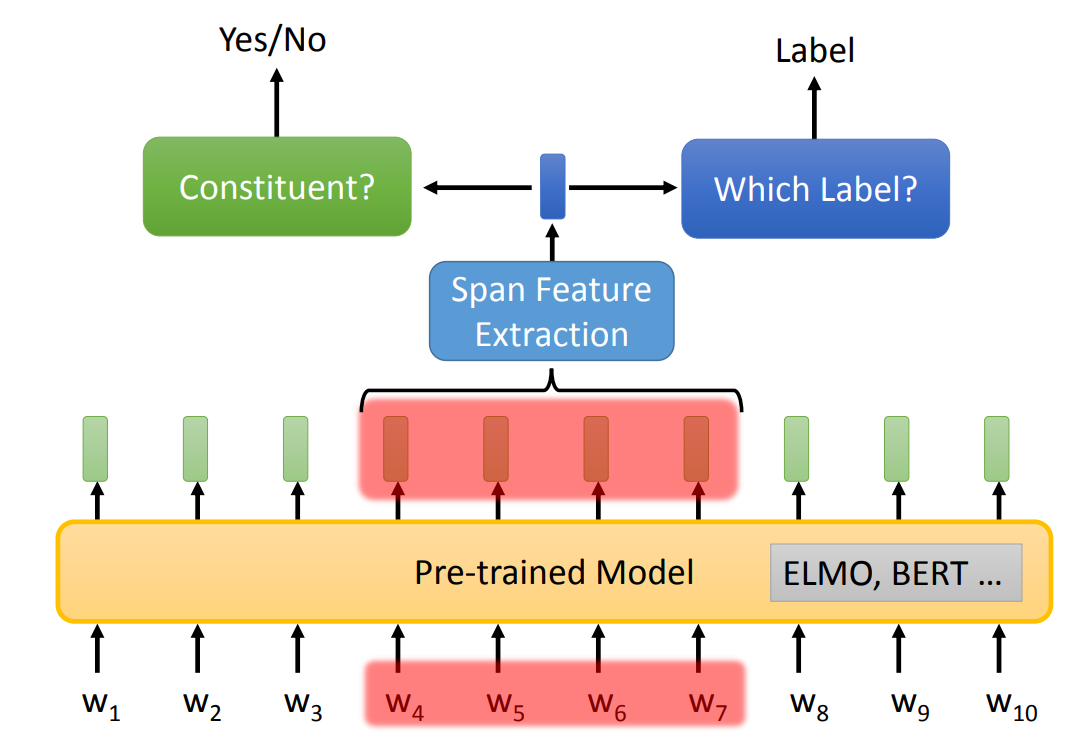
1655893866459


需要注意的是,对于 span 的选择可能会产生矛盾,比如两个重合的 span 都被判断出是 constituent,那么就无法组成一棵树。
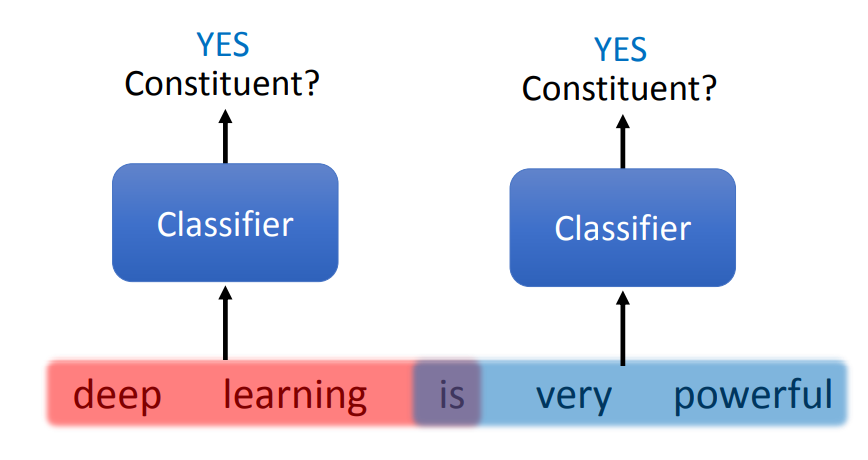
1655894066479

解决方法就是,穷举出所有可能性的树,然后对每一棵树进行评分,选取评分最高的树。

Transition-based

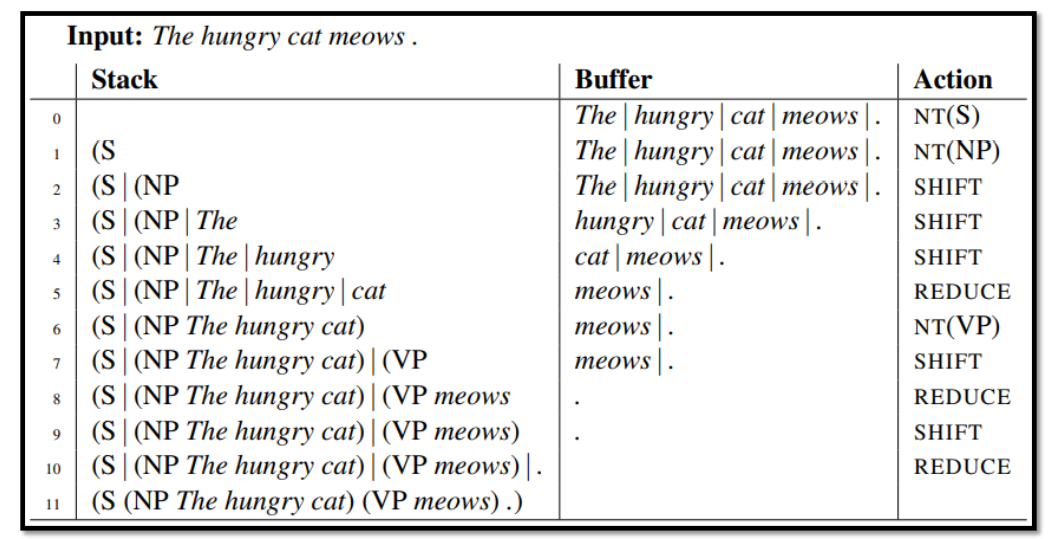
Transition-based 中由三个部分组成:

  • Stack:初始为空。
  • Buffer:初始存放整个句子。
  • Actions:包括三种操作
    • NT (X):创建一个带有 X 标签的 constituent
    • SHIFT:将一个 token 从 Buffer 移动到 Stack 中
    • REDUCE:结束一个 constituent

1655894315635

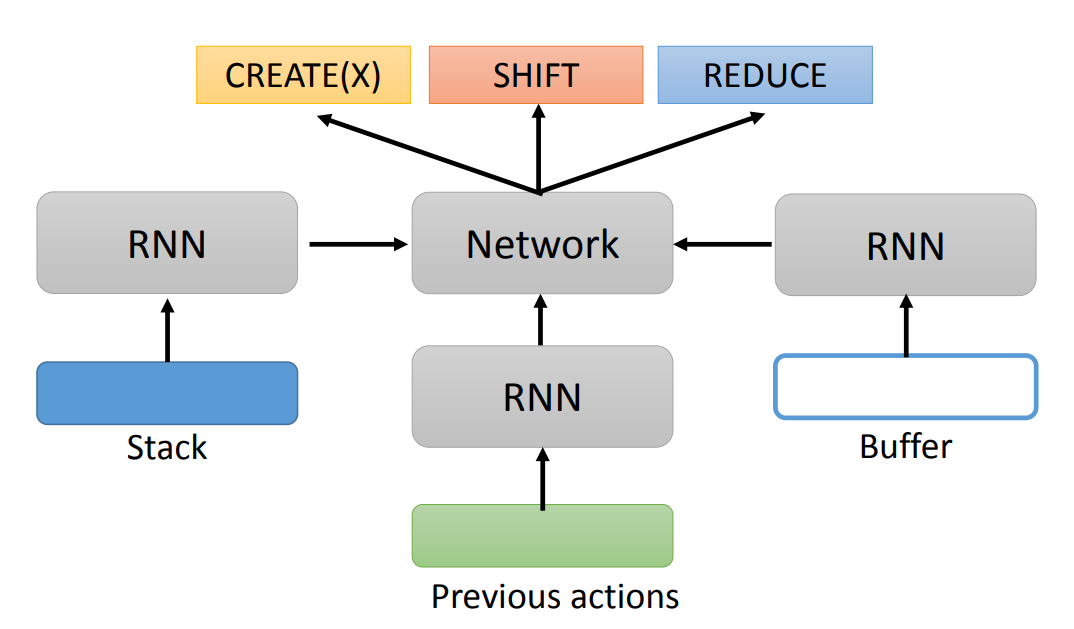
实际上,我们需要训练一个分类模型,用于输出 Actions。

1655894356049

Tree to Sequence

甚至,我们可以利用 Seq2seq Model,将语法树变为一个 Sequence,比如:

对树进行遍历,得到遍历序列,这个遍历序列就是 Sequence。需要注意的是,这个模型不需要输出单词(因为可能会改变输入的句子),可以用 XX 表示输入的一个单词。
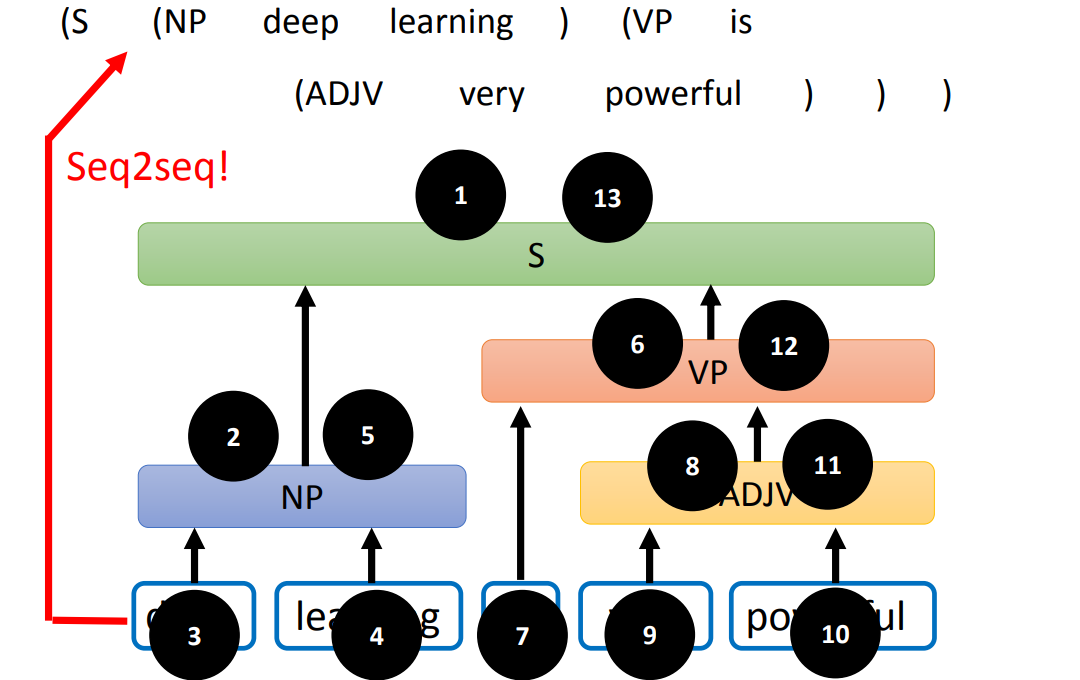
1655894496403

Dependency Parsing

Constituency Parsing 考虑的是一个句子中,相邻单词的关系。

Dependency Parsing 考虑的是任意两个单词(不需要相邻)的关系,用箭头表示这种关系(标签为关系的类别),起始为 head,结束为 dependent。
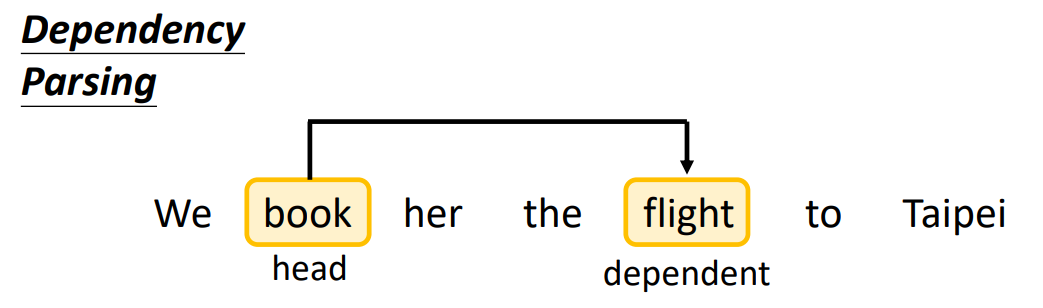
1655894898468

Dependency Parsing就是将一句话变为有向图(Directed Graph,实际上也是一棵树),word 变为 node,关系变为 edge。
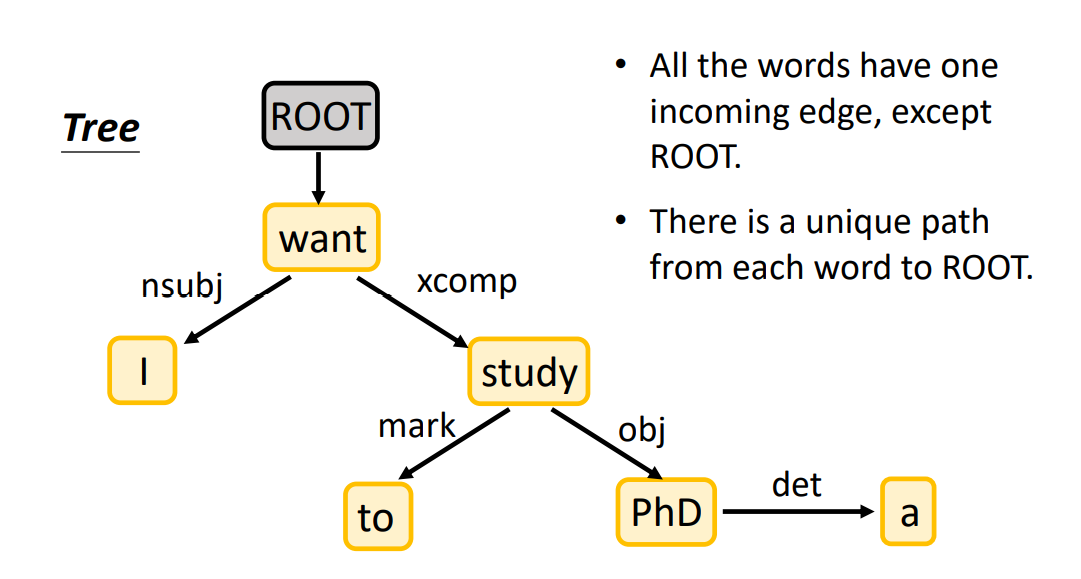
  • 所有 word 只有一个入边(除去 ROOT)。
  • 从每一个 word 到 ROOT 有唯一的一条路径。

1656986928287

核心方法就是:两个分类器,输入是两个 word。

  • 判断左边是否指向右边。
  • 判断属于哪一种关系。

1656987793280

Self-Attention 机制

将各个向量放入 Self-Attention(可以使用多次) 中,得到与整个句子都相关的另外的向量。
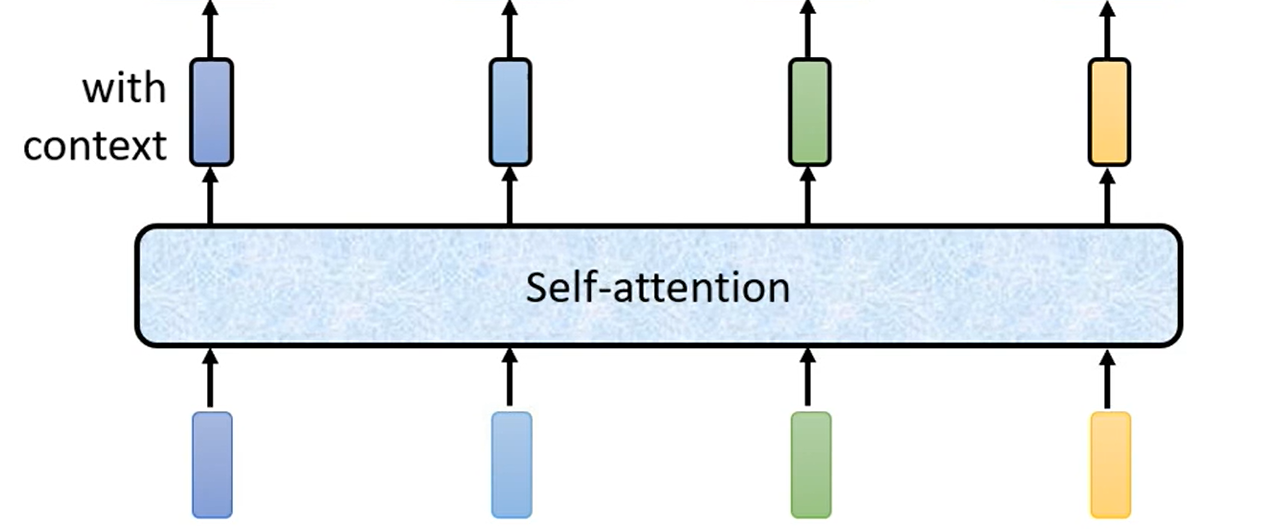
1655719447203

结构

Self-Attention 层,输入一些向量,输出另一些向量。每一个输出的向量与输入的向量都有关系。
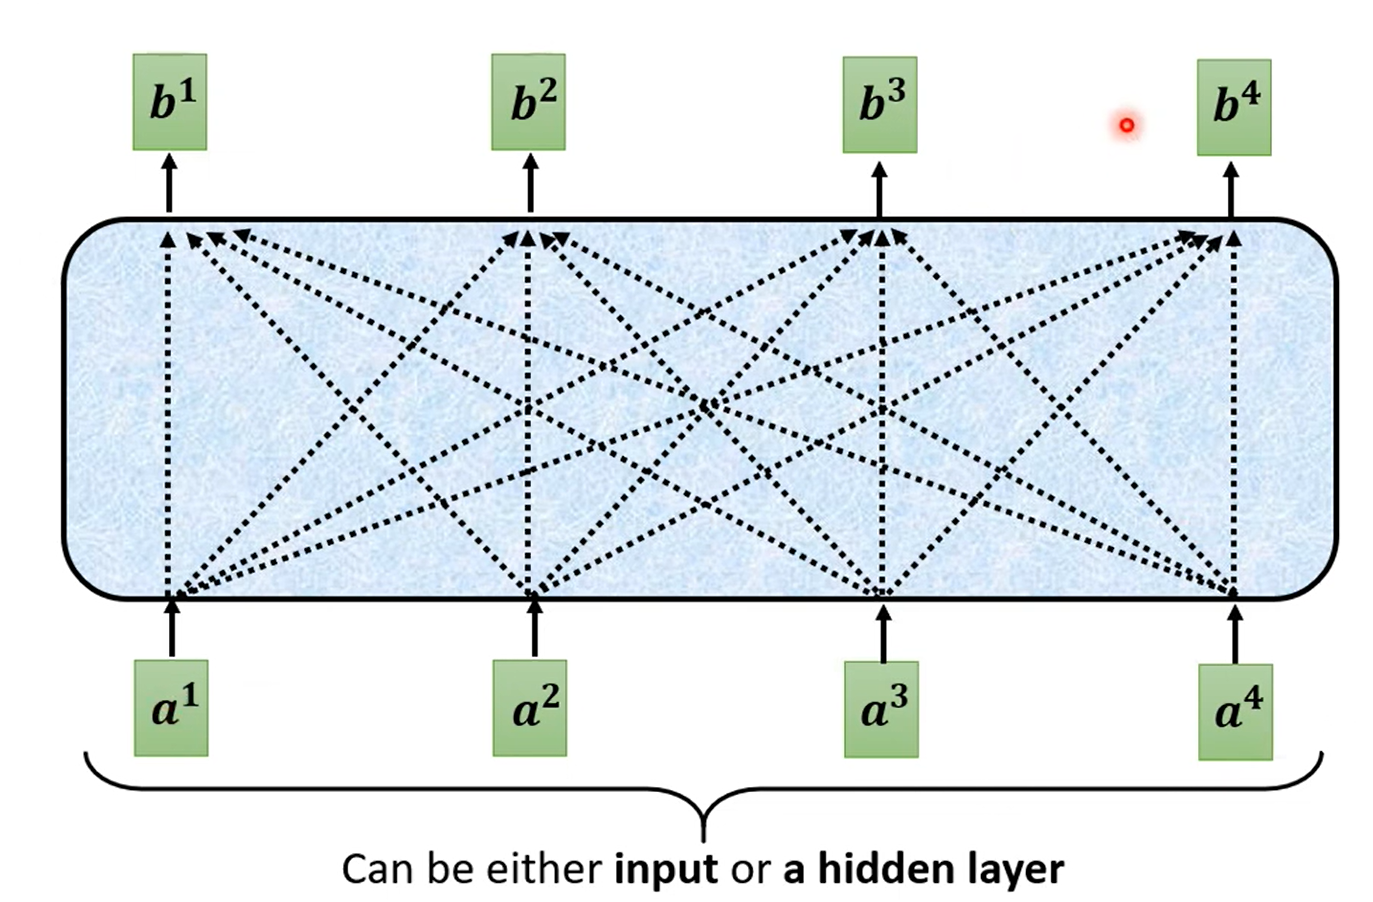
1655719567664

对于如何输出一个向量,实际上是看其他向量是否对应的输入有关系(relevant)。这里的有关系的程度用 α 表示:
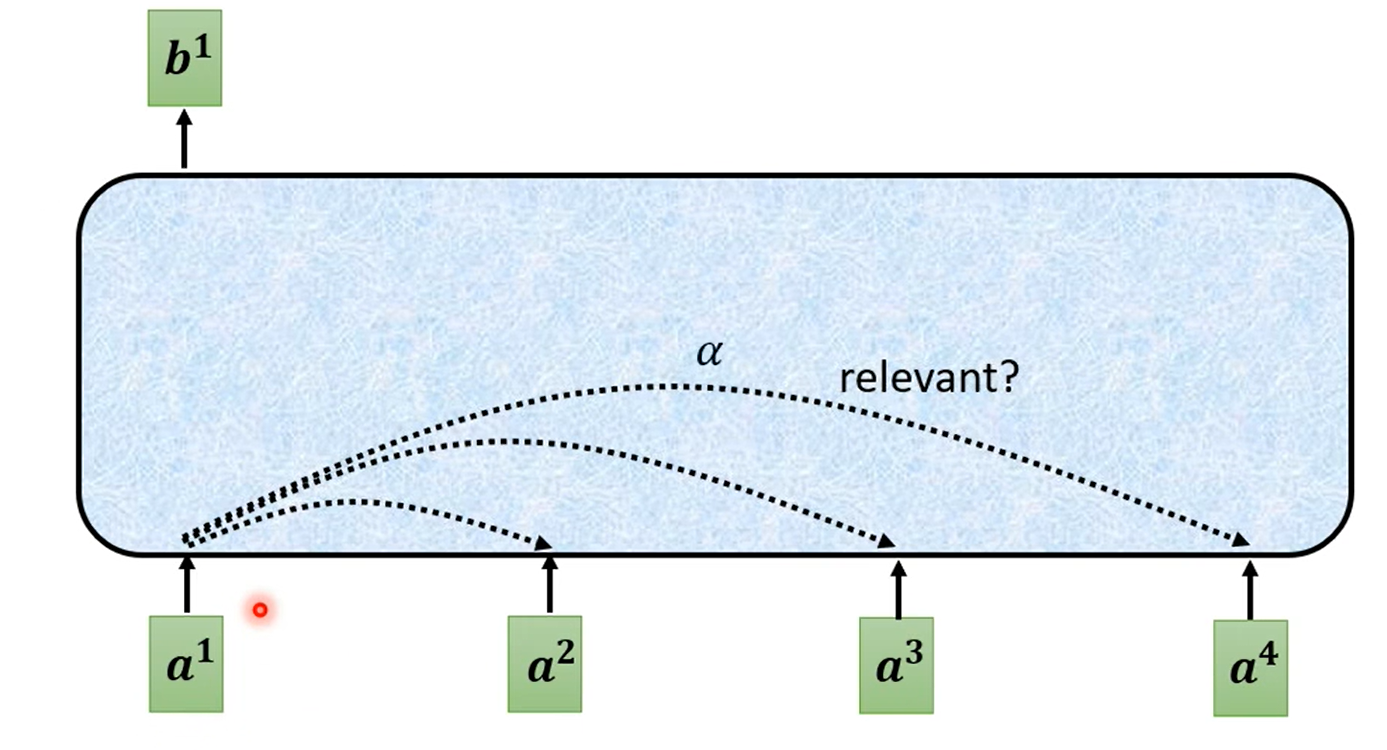
1655719768962

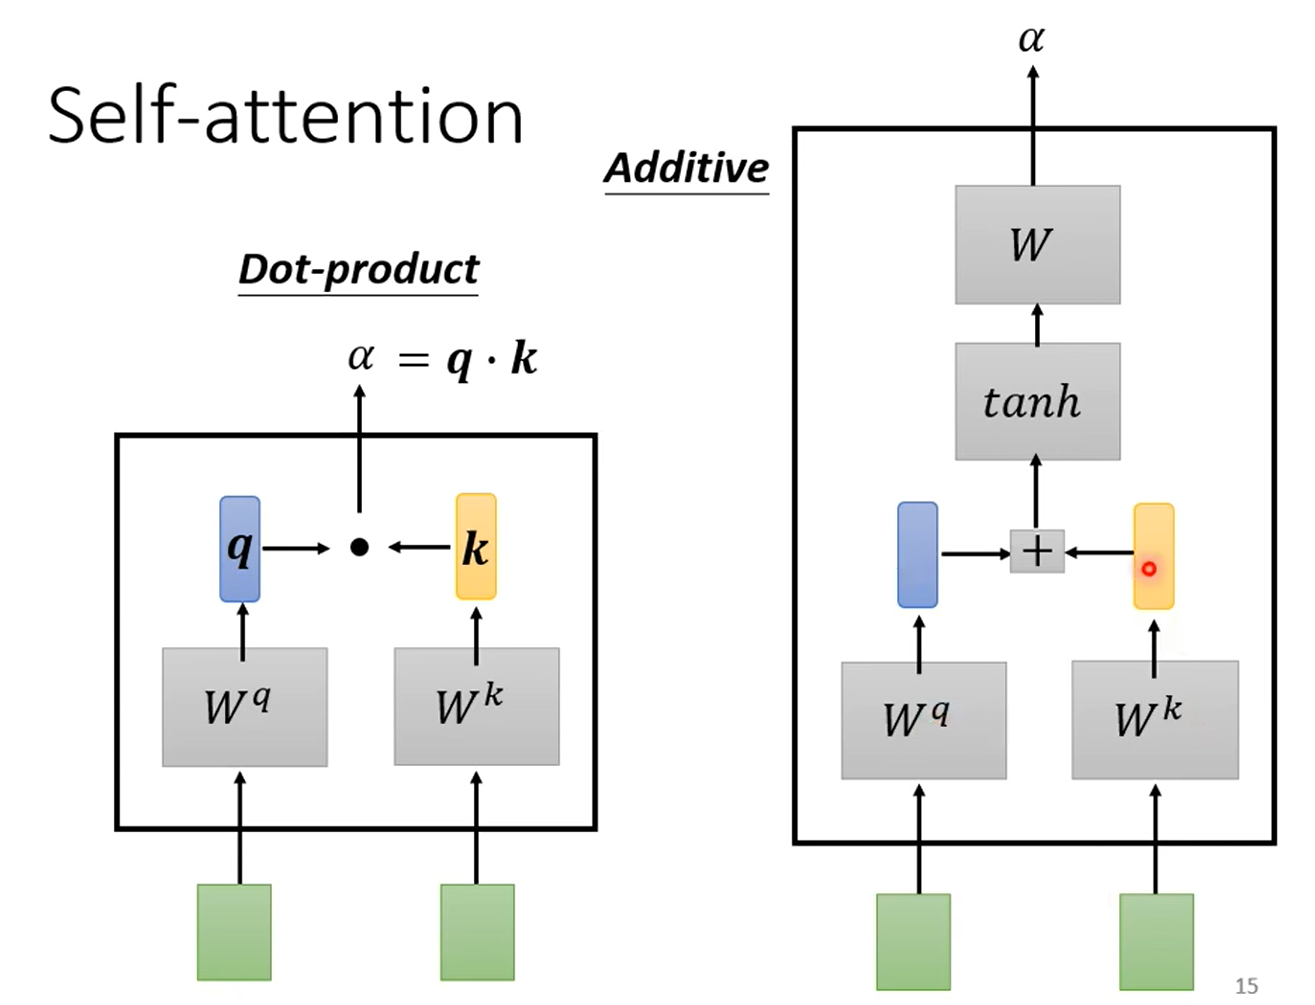
对于如何计算 α,有两种方式:

  • Dot-product:输入向量乘以一个矩阵 W,之后再做点乘,点乘结果为 α。(transformer使用)
  • Additive:输入向量乘以一个矩阵 W,相加之后进入 tanh,最后经过线性变换得到 α。

1655719747182

过程

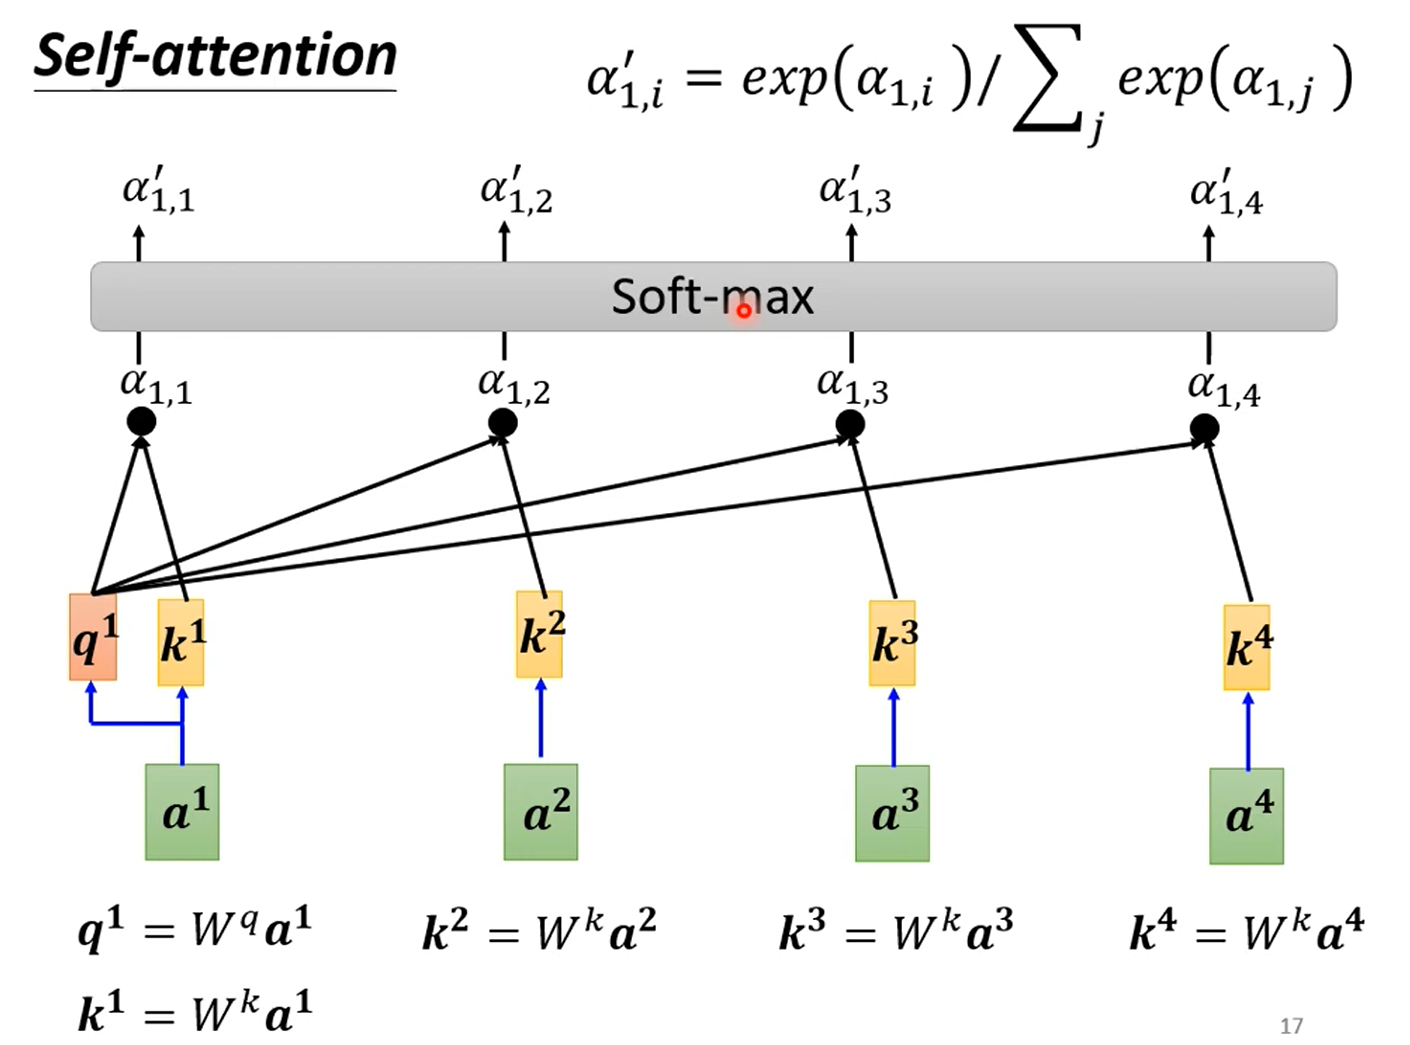
  • 得到相关性分数 α:首先输入乘以矩阵得到向量 q 和 k,将 q 和 k 点乘(dot-product)后进入 soft-max(作用是 normalization,也可以用其他的) 层:

1655721797344

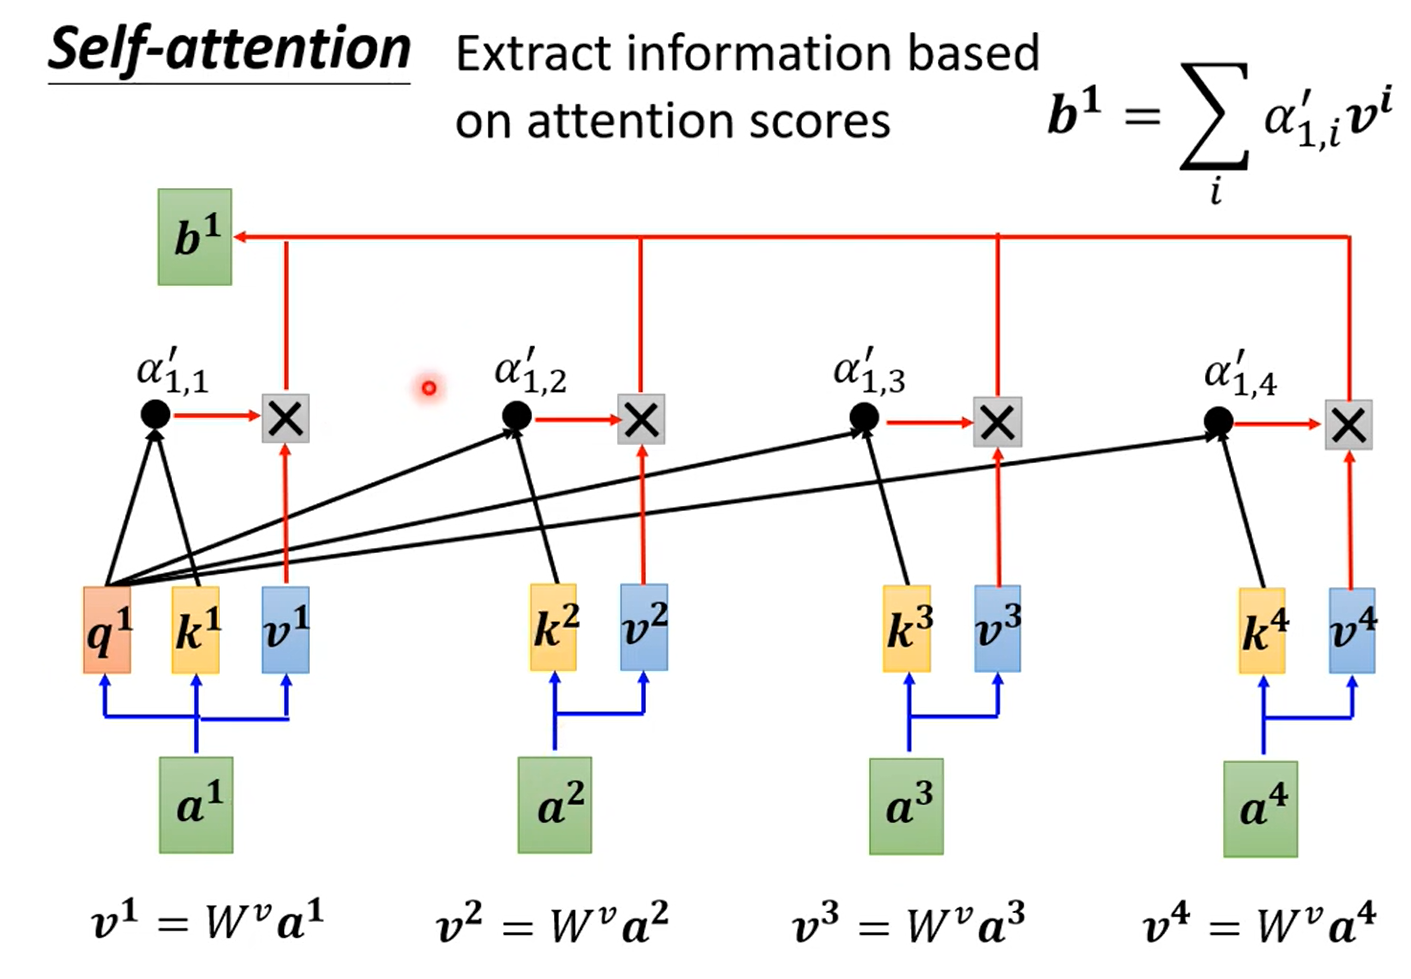
  • 根据 α 提取信息:将输入与矩阵相乘得到向量 v,再与 soft-max 的输出相乘并相加得到 Self-Attention 的输出 b。相关性大,则 α 大,所以输出中对应 v 的占比越高。

1655721841471

Multi-head Self-Attention

这是 Self-Attention 的变形,用于计算不同种类的相关性。

最大的不同就是 q、k、v 三种向量乘以多个矩阵(矩阵的个数就是 head 的数量,即种数)得到不同的种类,每一种单独 Attention 得到每一种对应的输出。
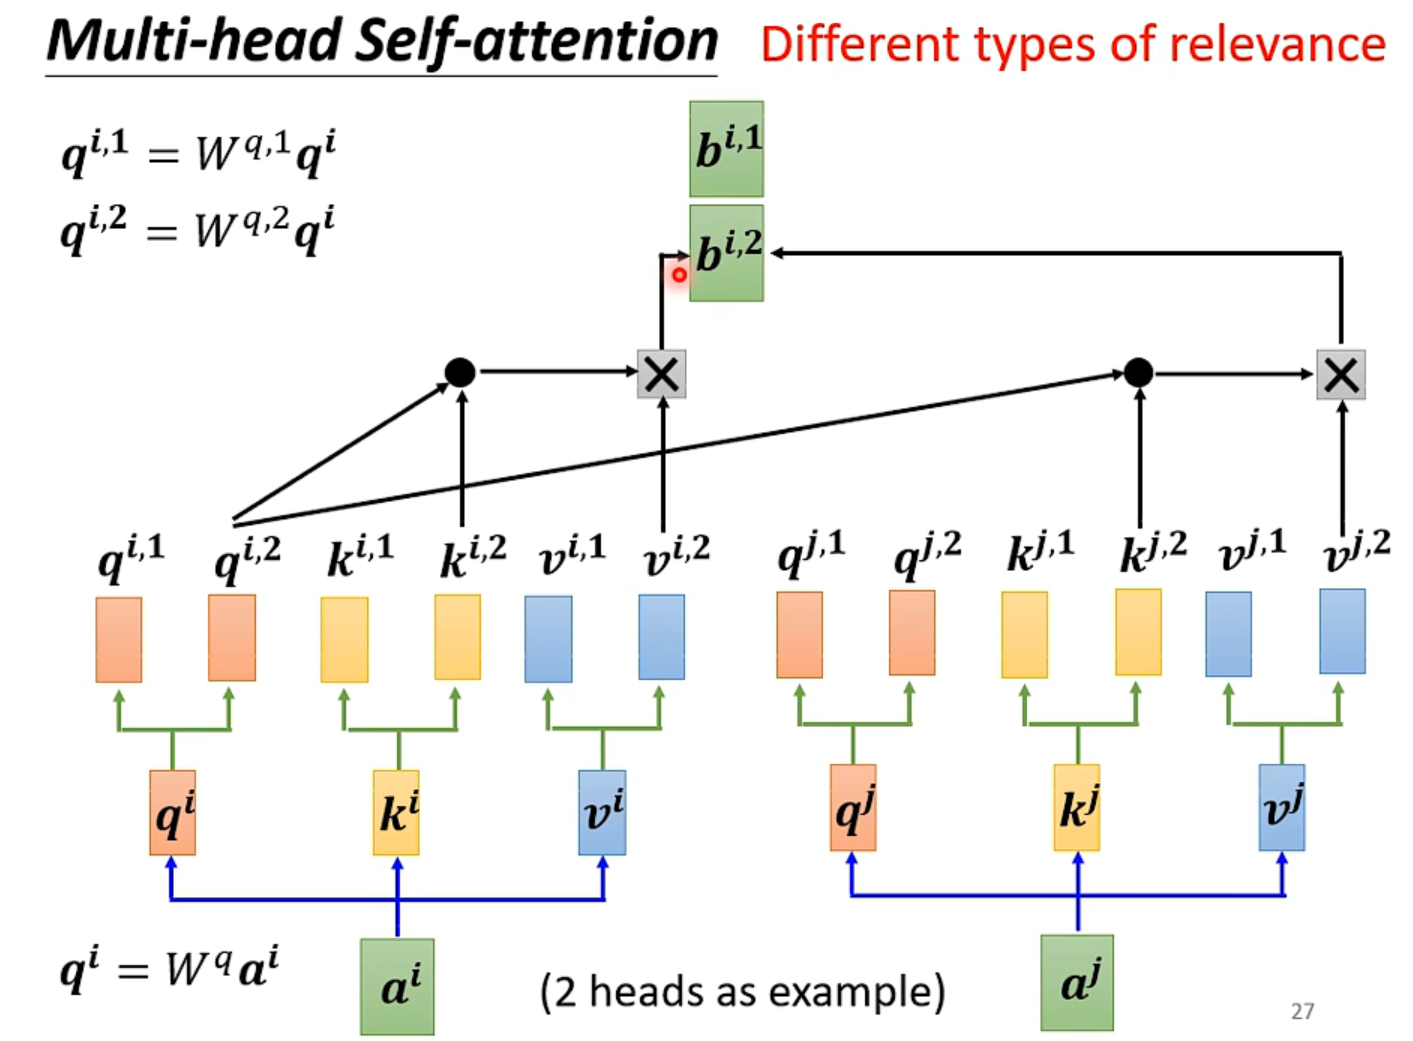
1655722732610

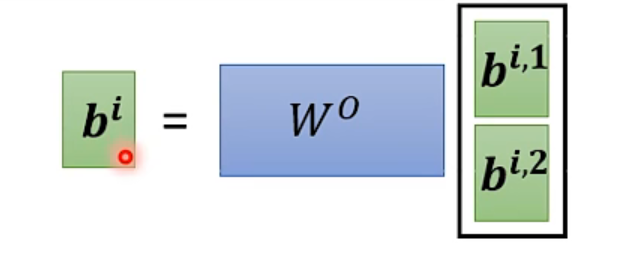
最后将每一种输出乘以一个矩阵,得到最终的输出。

1655722841770

加上位置信息 - Positional Encoding

上述的 Self-Attention 中,是没有位置信息的。若需要位置信息,则需要 Positional Encoding。具有工作如下:
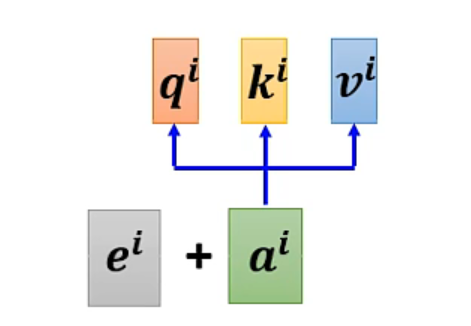
  • 每一个位置 i,都有一个唯一的位置向量 ei
  • 输入加上位置向量之后再 Attention 即可

1655723108847

Transformer

Transformer 是一种 Seq2seq Model(输入一个 sequence,输出一个 sequence)。

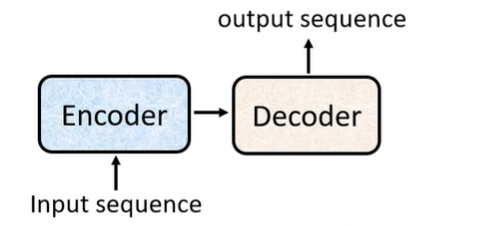
Seq2seq 结构

Seq2seq Model 的结构包括一个 Encoder 和一个 Decoder。
1655809629816

Encoder

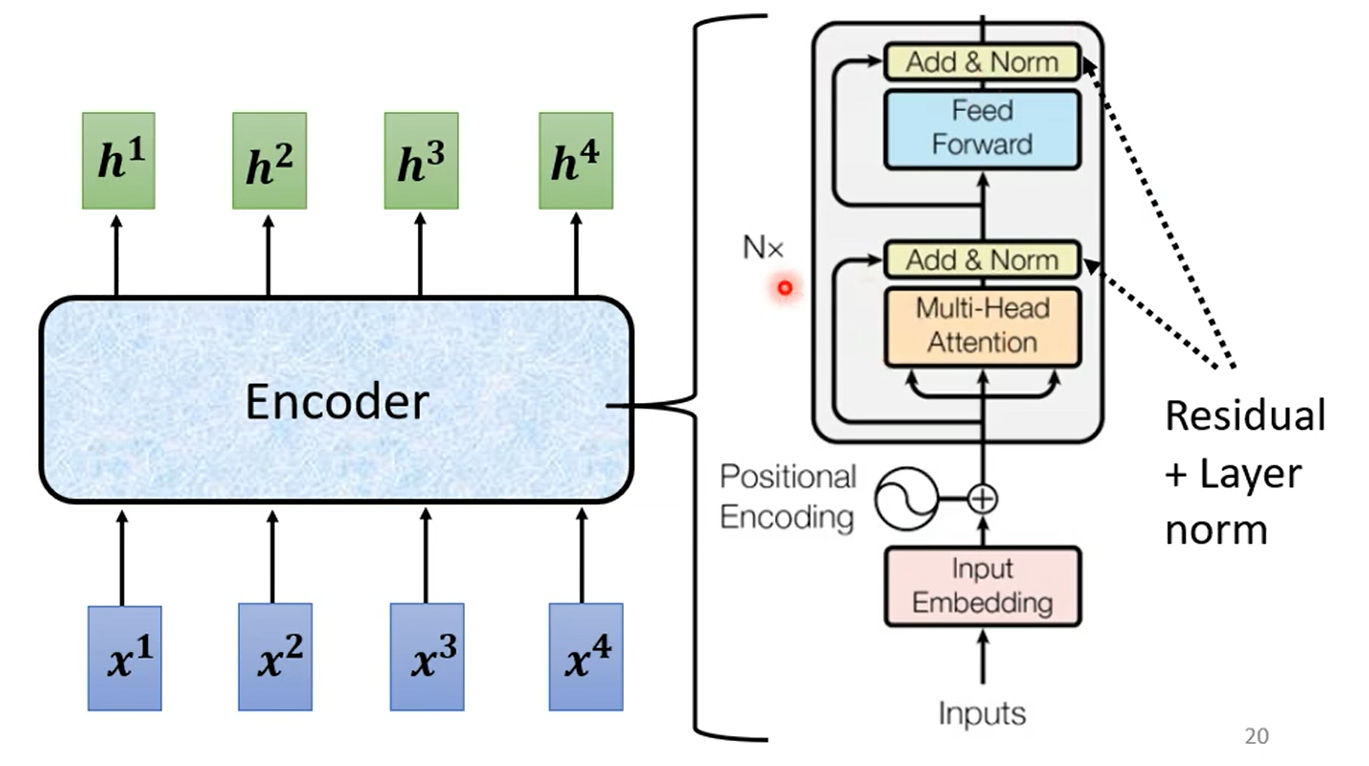
Encoder 输入一排向量,输出另外一排向量。

1655809876570

其中 Encoder 是 N 个 block 的重复,每一个 block 的结构如下:
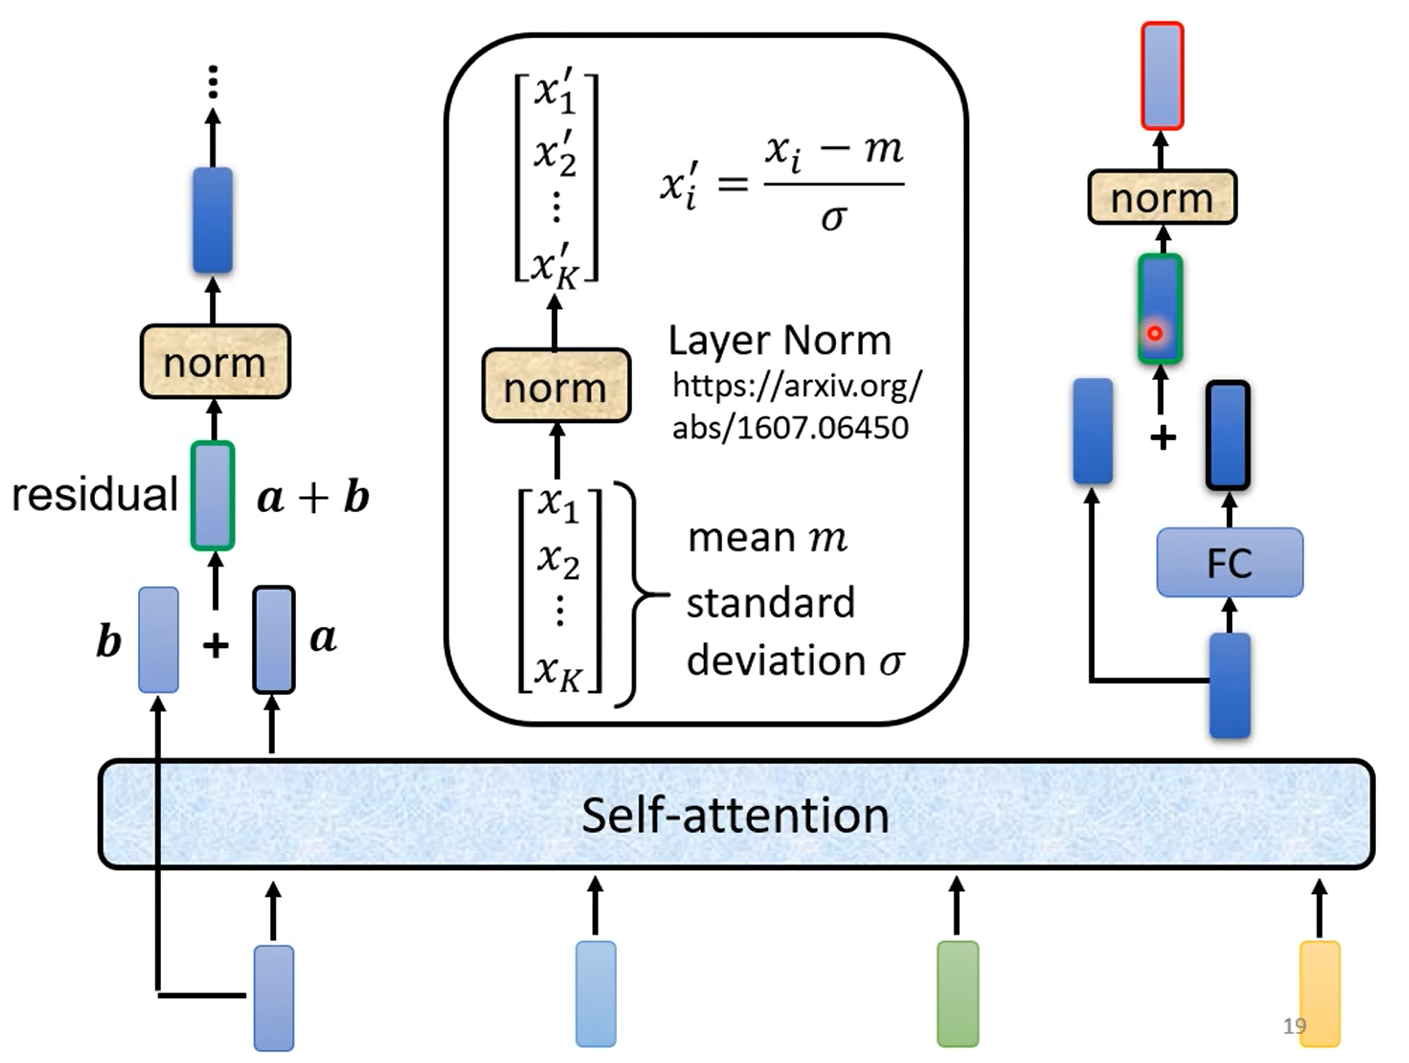
  • Self-Attention
  • Residual + Norm
  • 全连接层(上图中 Feed Forward)
  • Residual + Norm

1655809982256

Decoder

Autoregressive(AT)

Autoregressive 就是在输出时,从左到右依次输出。其最显著的特点就是,每一个 Decoder 的输出作为下一次 Decoder 的输入。

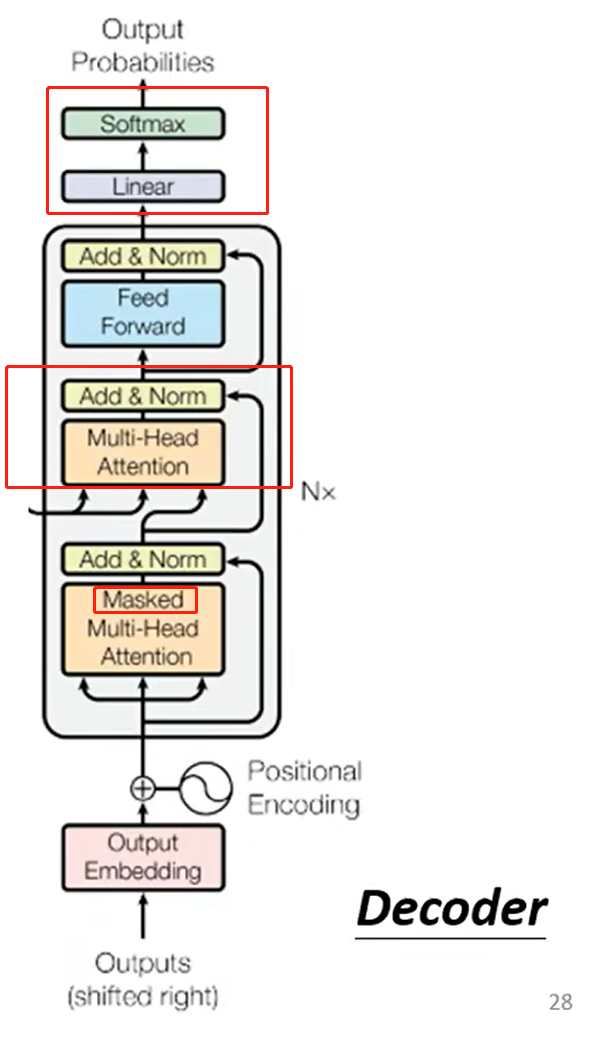
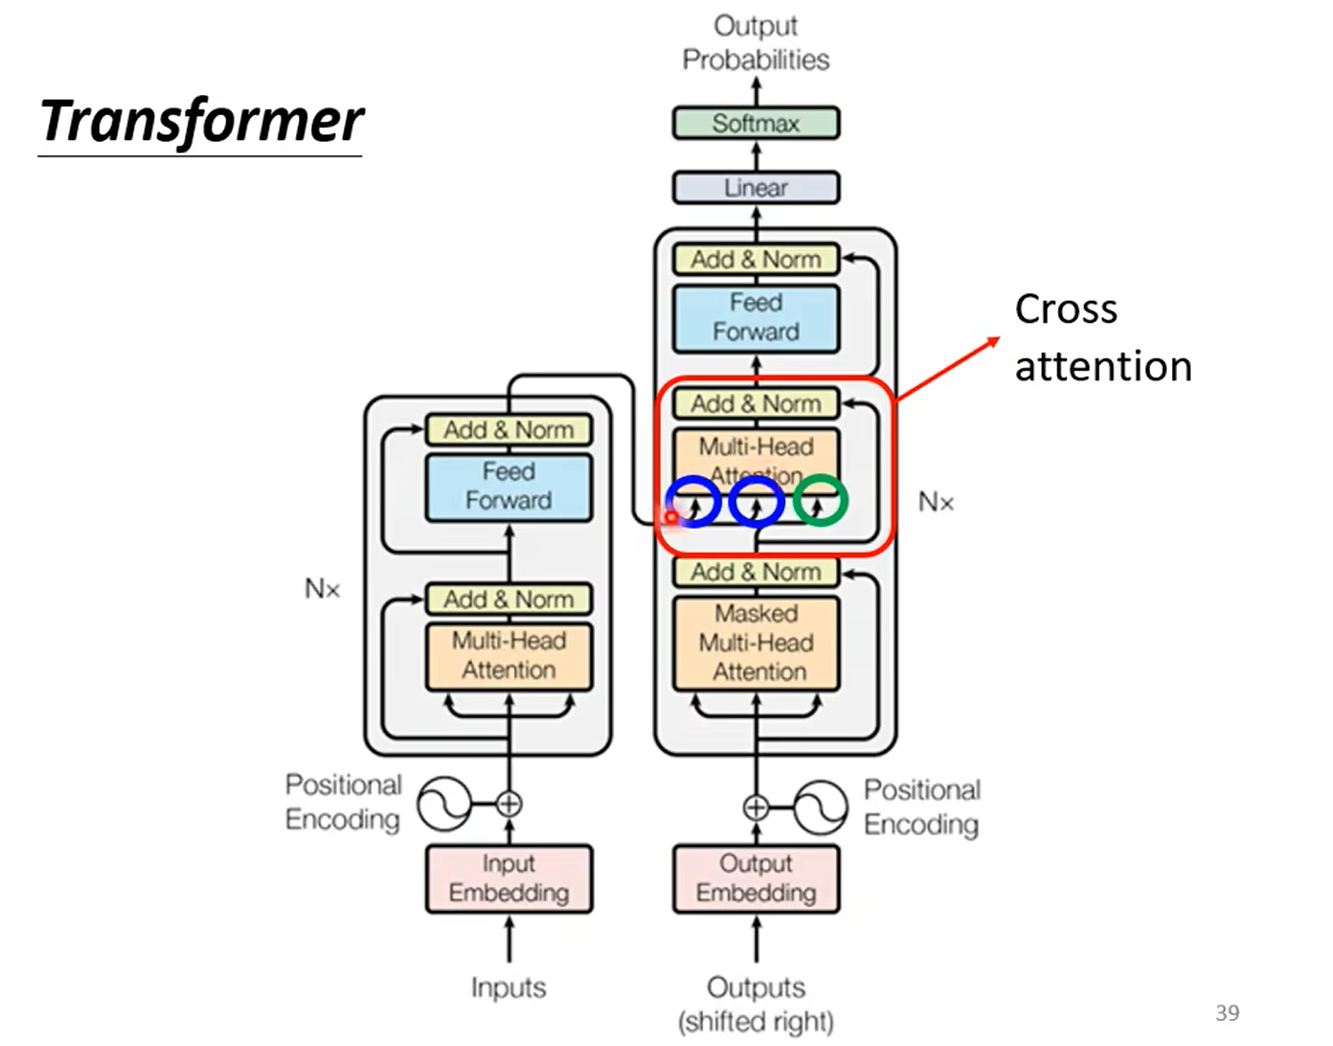
Decoder 和 Encoder 的结构比较类似,区别在于:
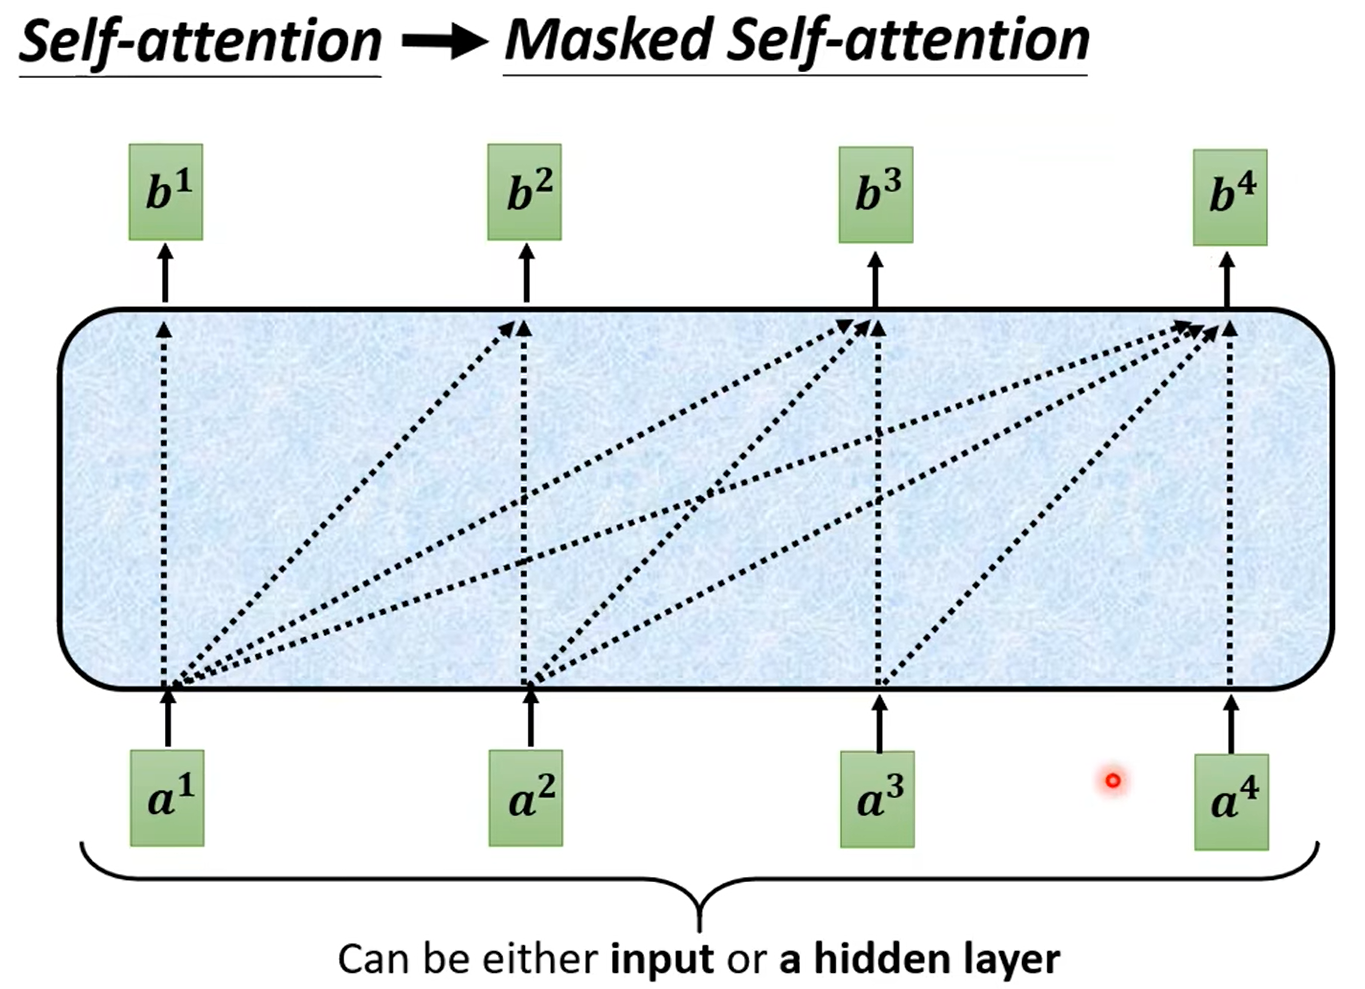
  • 第一个 Attention 变为了 Masked Multi-Head Attention(Encoder中为 Multi-Head Attention):Mask 的含义就是每一次 Attention,只看前面的向量,不看后面的向量。

1655811020124

  • 增加了一层 Multi-Head Attention 和 Add & Norm
  • 最后一个 block 的输出进入线性层和 soft-max 层,输出的是最大可能性对应的结果(将这个输出放入下一次 Decoder 的输入)。

1655810751137

Non-autoregressive(NAT)

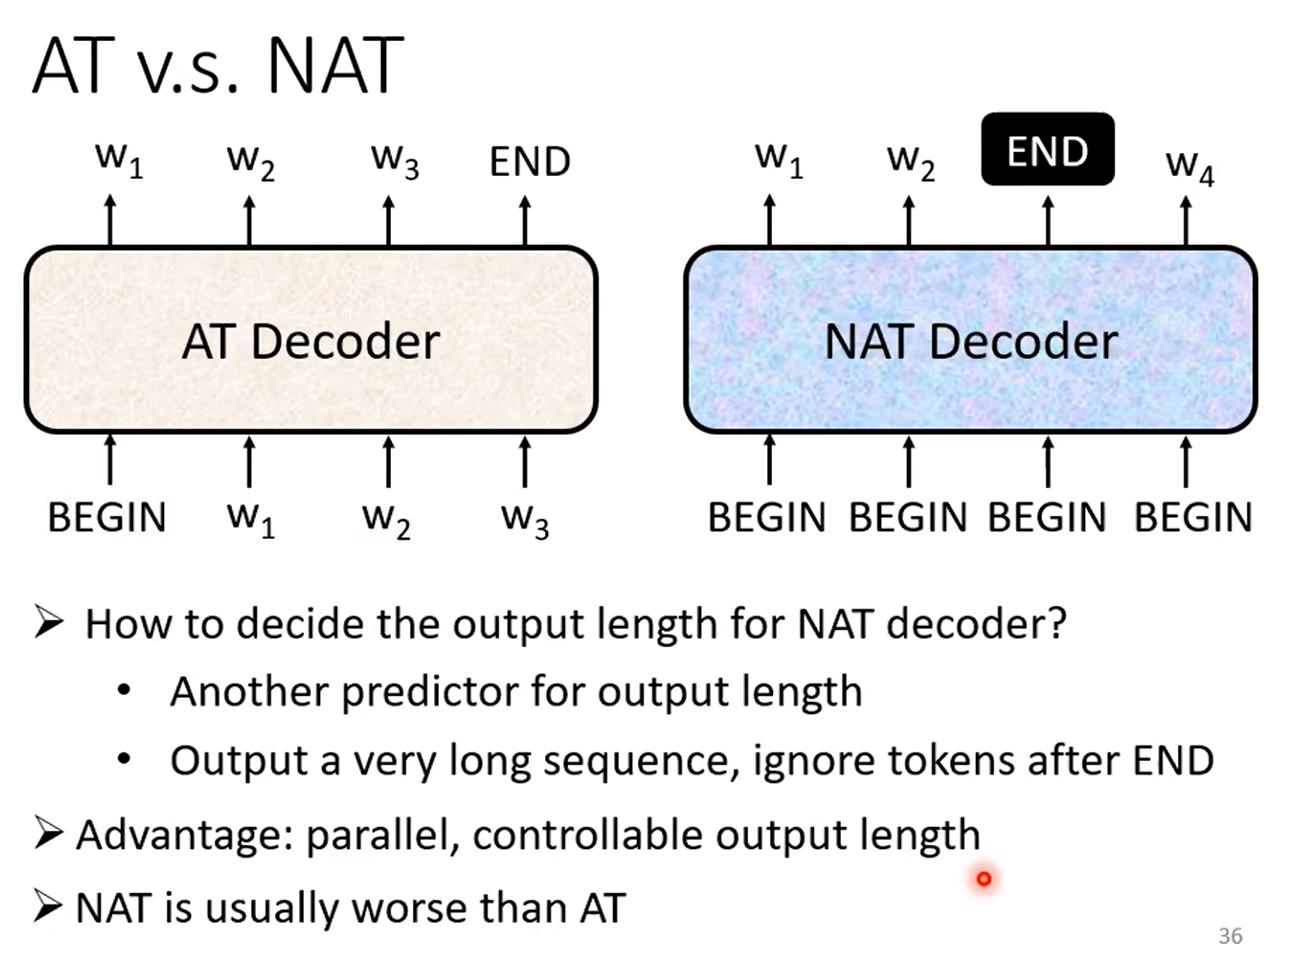
AT 和 NAT 的比较:

  • AT 将 Decoder 的输出作为下一次 Decoder 的输入;NAT 输入的只有 BEGIN token,输入不会进入 Decoder 的输入。
  • 如何得到 NAT 的输出长度?(Seq2seq 输出长度是不确定的)
    • 训练一个 Model 进行输出长度的预测。
    • 输出一个很长的 sequence,忽略 END token 之后的东西。
  • NAT 的优点:
    • 可以并行化计算,因为不用等待上一个 Decoder 的输出。
    • 可以控制输出长度。
  • NAT 通常比 AT 表现更差。

1655811450753

Encoder-Decoder 之间的连接部分

实际上,Decoder 中多出的一层 Multi-Head Attention 和 Add & Norm,就是用于连接 Encoder 和 Decoder。

这一部分被称为 Cross Attention。
1655811789284

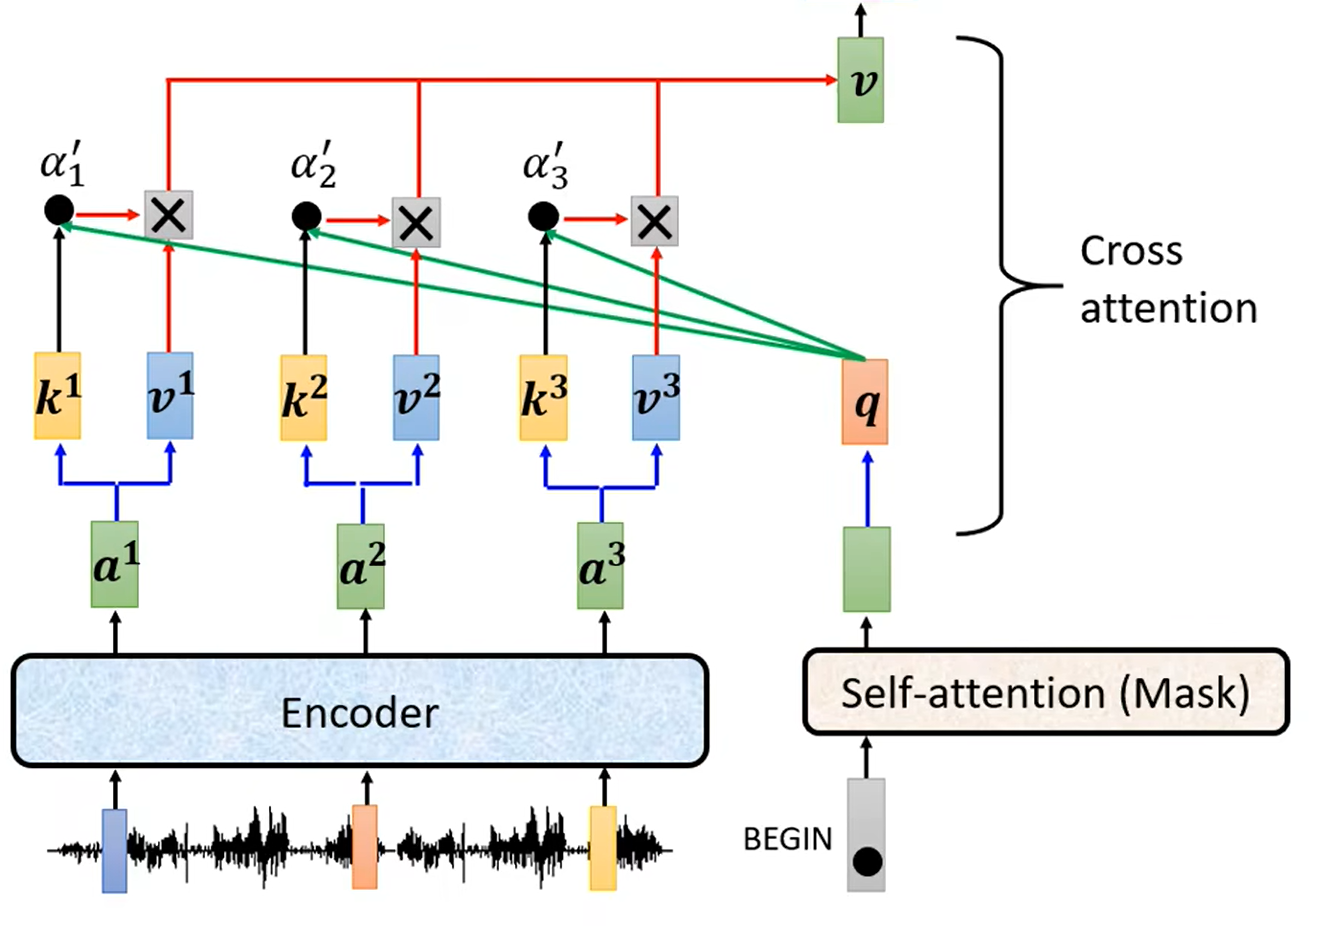
Cross Attention 的详细结构如下,计算 Decoder 中 Masked Multi-Head Attention 的输出向量与 Encoder 的输出之间的相关性(Attention)。
1655811904635

如何训练

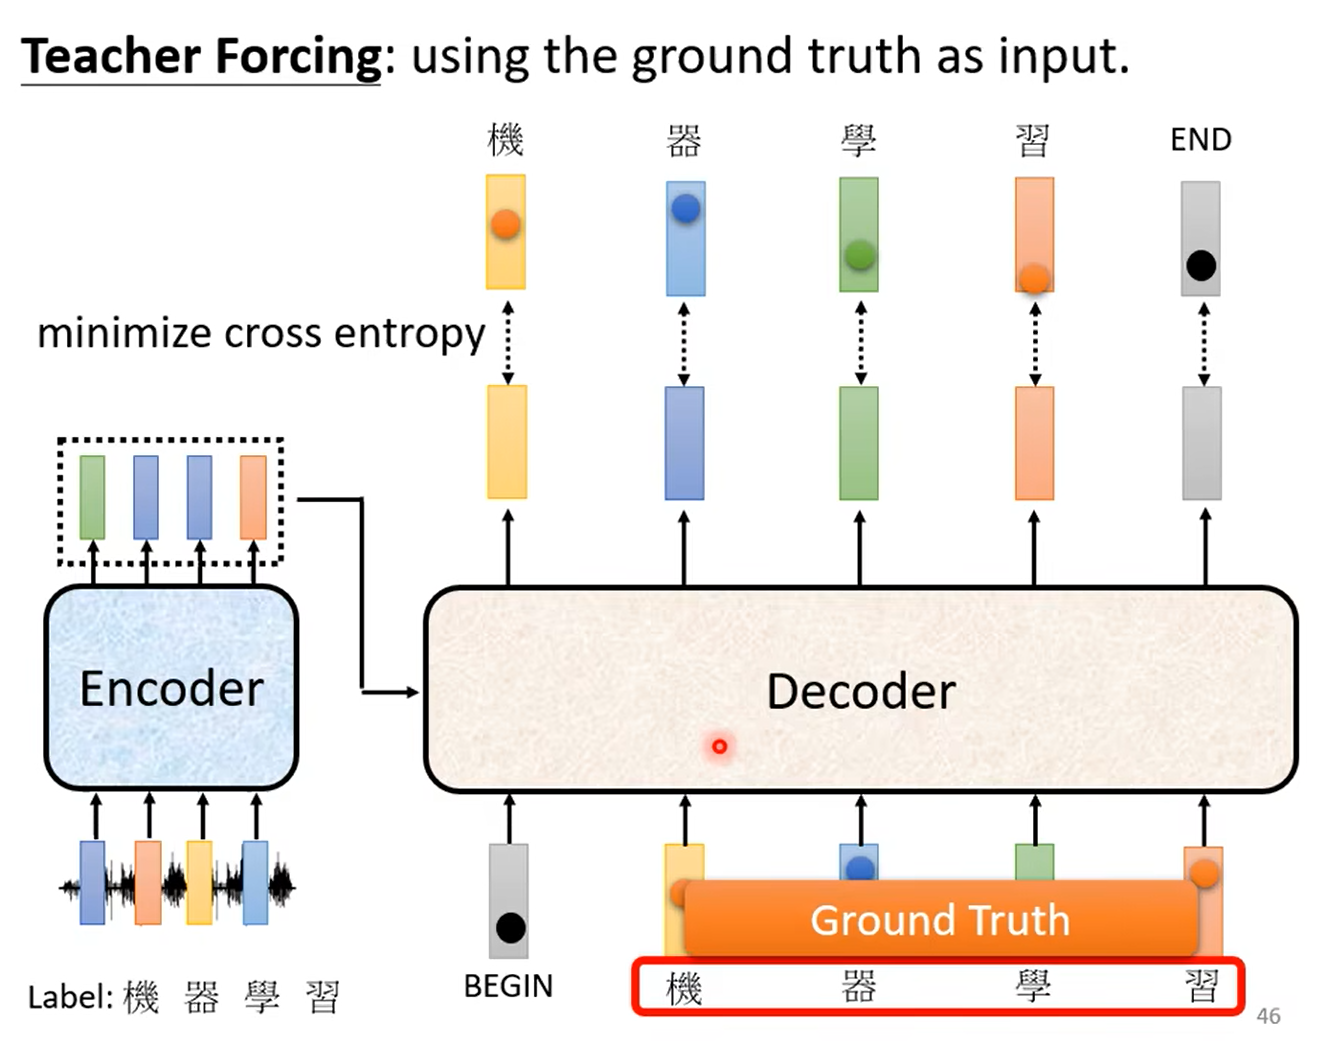
训练时,采用强制学习(Teacher Forcing):每一次向 Decoder 的输入并不是上一次 Decoder 的输出,而是正确的结果。
1655812460812

Coreference Resolution

Coreference Resolution,即代指消解,识别出代指的相同的东西。

需要识别出代指的一段文字(如他、它的 XX 等),称为 mention。代指消解的结果就是将同一个代指的 mention,放入同一个 cluster 中。

步骤

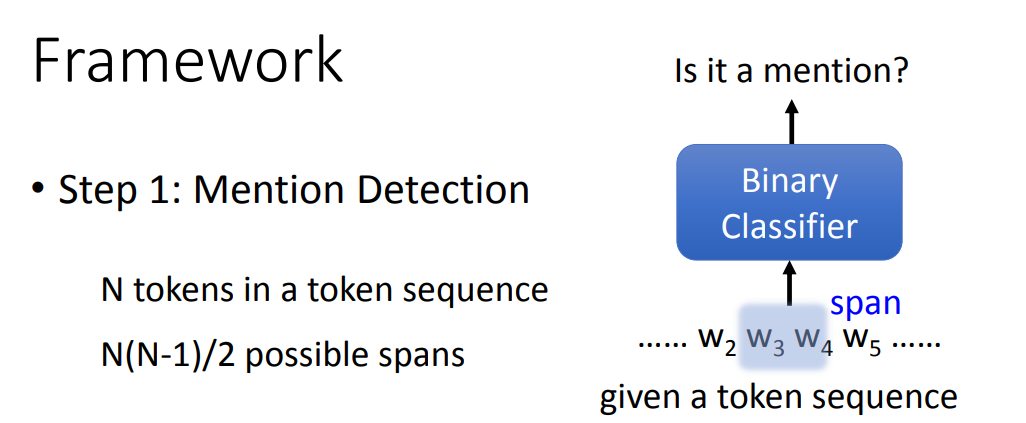
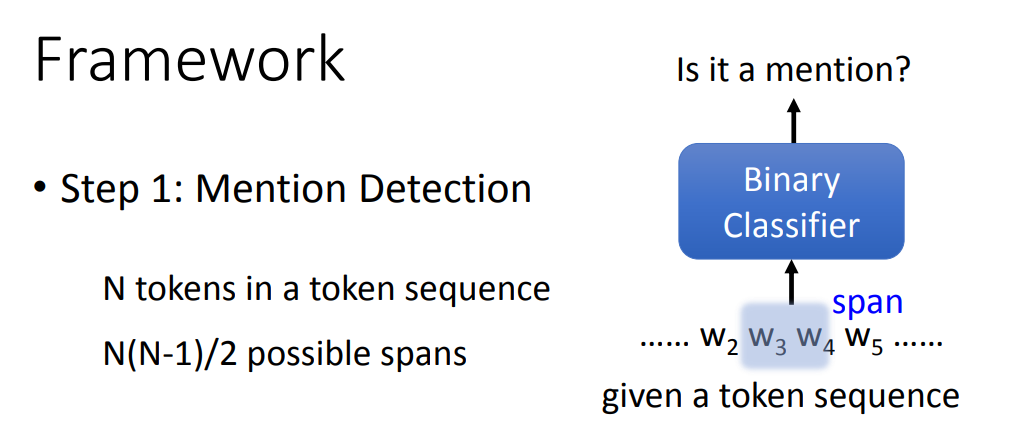
  • 识别出 mention:需要一个二分类器,输入一个 span,判别是否是一个 mention。若有 N 个 token 的句子,需要运行 N(N-1)/2 次。

1655291452800

  • 识别哪些 mention 需要放在同一个 cluster 中:同样需要一个二分类器,输入为两个 mention,输出判断是否属于同一个 cluster。若有 K 个 mention,需要运行 K(K-1)/2 次。

1655291785154

或者可以直接输入两个 span 到二分类器中,判断这两个 span 是否代指同一个实体。若有 N 个 token,则有 K=N(N-1)/2 个 span,需要运行 K(K-1)/2 次。
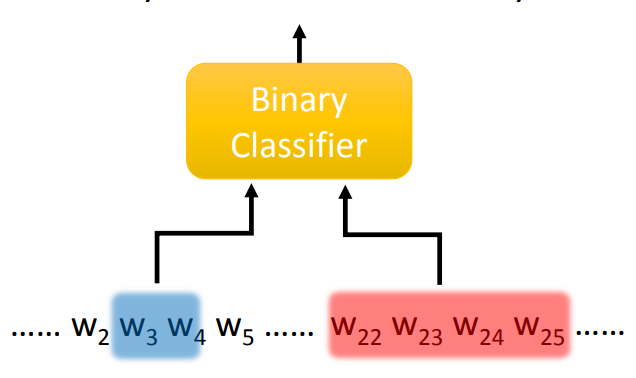
1655291986984

训练二分类器

一个通常的用于 Coreference Resolution 二分类器如下:

  • 将句子中的所有 token 输入预训练模型中,得到 embedding。

  • 将 embedding span 输入 Span Feature Extraction,得到两个向量(每一个 Span Feature Extraction 将 embedding 汇聚成一个 embedding)。

  • 判断两个向量是否是 mention、是否属于同一个 cluster,最终输出一个分数。
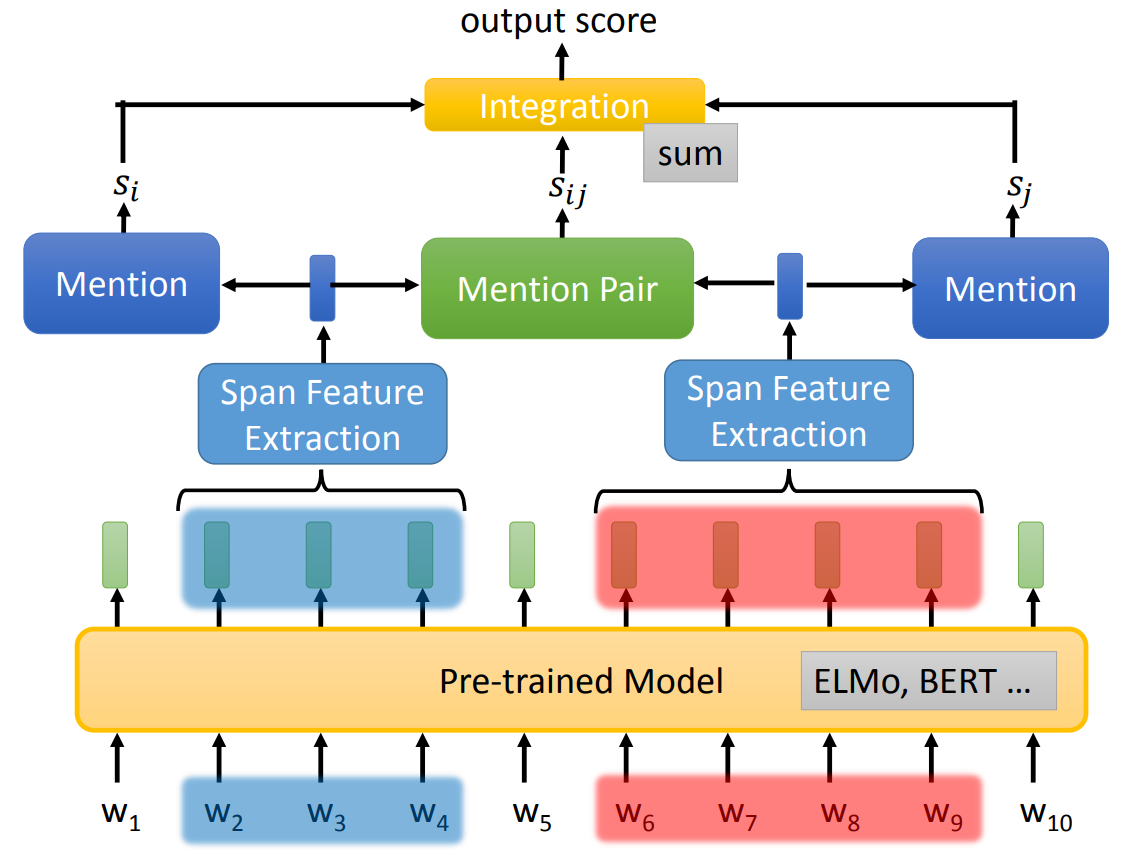
1655292350102

对于 Span Feature Extraction,结构如下。将 embedding span 进行 Attention,得到一个 Attention 向量,再把 span 中起始 embedding 和最后一个 embedding 与 Attention 向量相加,得到 Span Feature Extraction 的输出向量。
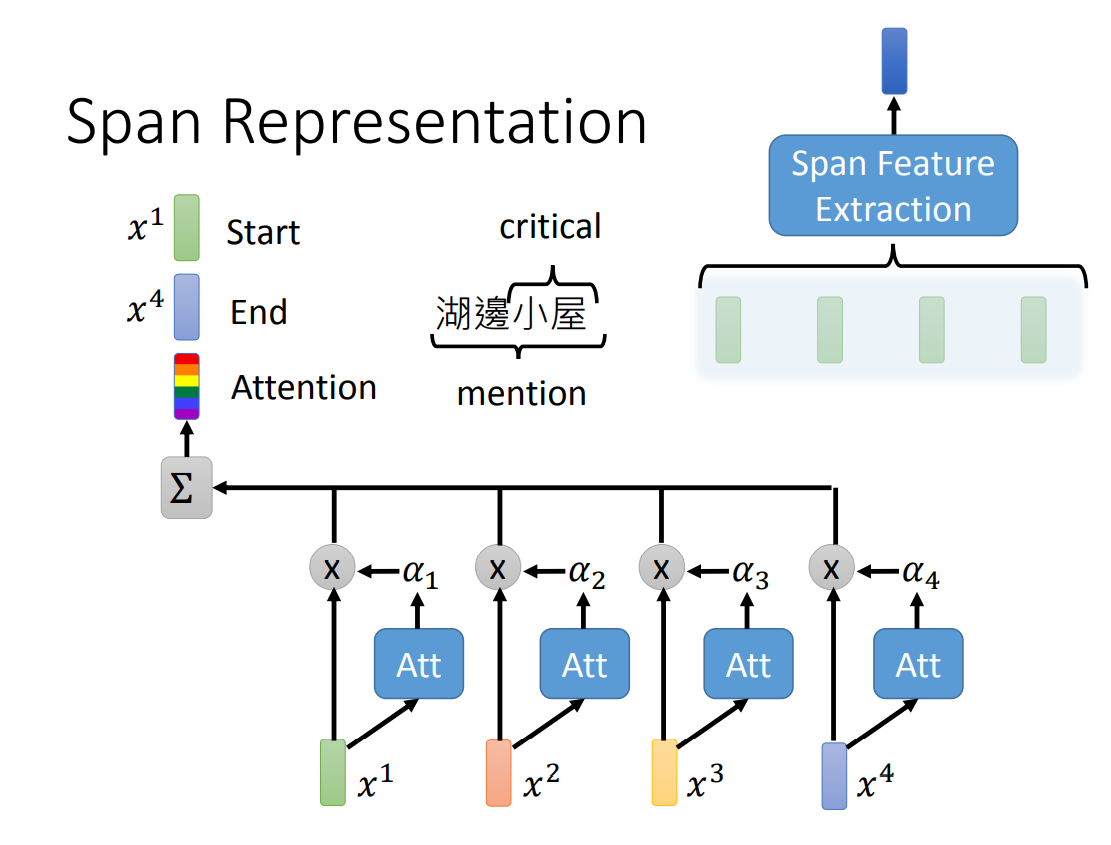
1655294345873


上述是有监督模型,那么是否可以训练一个无监督模型呢?

答案是可以的,把 mention Mask 起来,这样模型的输出就是相关的代指实体。
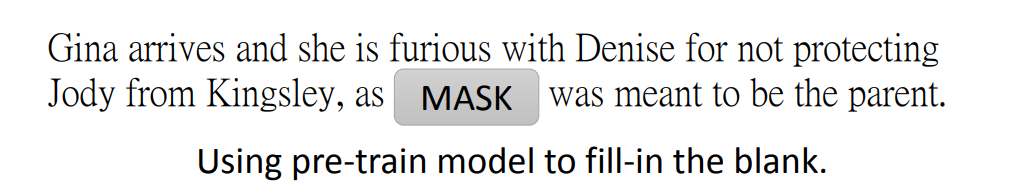
1655295040850

内存管理

Go 中,内存分配主要有两个思想:

  • 分块
  • 缓存

分块

分块的思路为:

  • 调用系统调用 mmap() 向 OS 申请一大块内存,例如 4MB。
  • 将内存划分为大块,例如 8KB,称为 mspan。
    • noscan mspan:分配不包含指针的对象,GC 不需要扫描。
    • scan mspan:分配包含指针的对象,GC 需要扫描。
  • 再将 mspan 划分为特定大小的小块,用于对象分配。

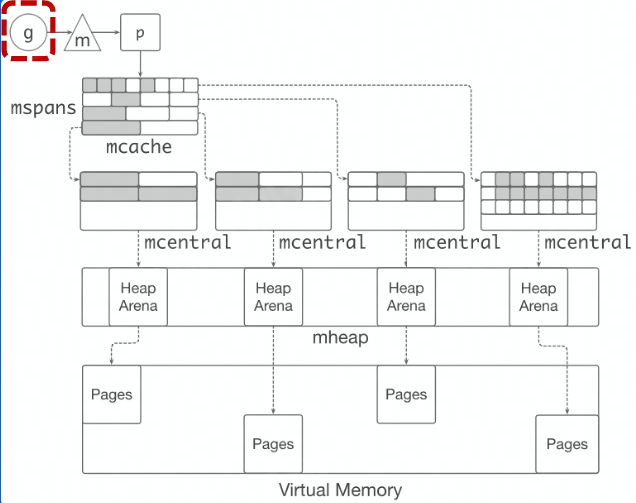
缓存

缓存的基本思路是:

  • 每一个 P 包含一个 mcache 用于快速分配,mcache 管理一组 mspan。
  • 当 mcache 中的 mspan 分配完毕,向 mcentral 申请带有未分配块的 mspan。
  • 当 mspan 中没有分配的对象,mspan 会被缓存在 mcentral 中,而不是立刻释放归还给 OS。

1655263401798

优化 - Balanced GC

字节跳动有自己的 Go 语言内存管理优化方案,即 Balanced GC,其思路如下:

每个 G 都绑定一大块内存(1 KB),称为 Goroutine Allocation Buffer(GAB)。
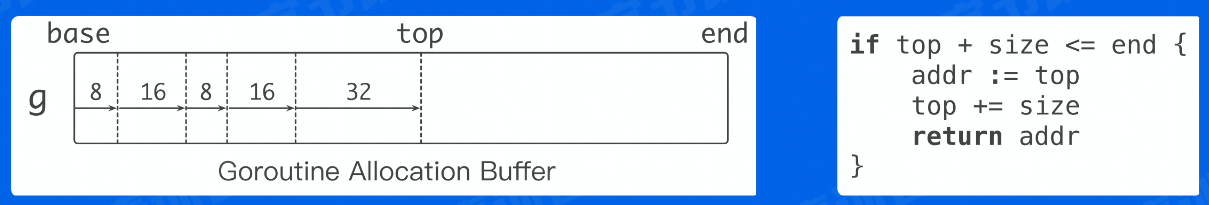
  • GAB 用于 noscan 类型的小对象(小于 128B)的分配。
  • GAB 使用三个指针进行维护:base、end、top。使用指针碰撞风格进行对象分配。

1655263925528

  • GAB 对于 Go 内存管理来说就是一个大对象。

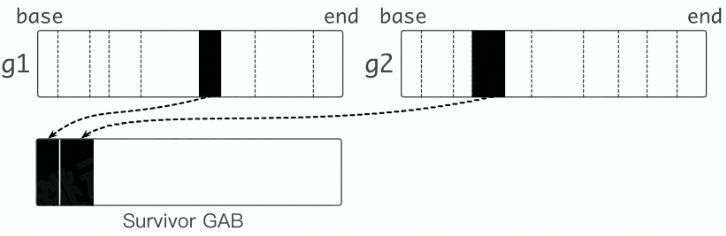
GAB 有一个问题:会导致内存被延迟释放,GAB 中即使只有一个很小的对象存活,Go 内存管理也不会回收其余空闲空间。

解决方法:

当 GAB 中存活对象大小少于一定阈值时,将 GAB 中存活的对象复制到另外分配的 GAB(Survivor GAB)中,原先的 GAB 可以释放。
1655264117801

编译器优化

函数内联

函数内联是指,将被调用函数的函数体的副本,替换到调用位置上,同时重写代码以反映参数的绑定。

优点:

  • 消除函数调用的开销,如传递参数、保存寄存器等。
  • 扩展了函数边界,更多对象不逃逸分析。

缺点:

  • 函数体变大。
  • 编译生成的可执行文件变大。

逃逸分析

逃逸分析步骤:

  • 从对象分配处出发,观察对象的数据流。
  • 若发现指针 p 在当前作用域 s:
    • 作为参数传递给其他函数
    • 传递给全局变量
    • 传递给其他 goroutine
    • 传递给已逃逸的指针指向的对象
  • 则指针 p 指向的对象逃逸出 s,反正没有逃逸。

对于未逃逸的对象,在栈上分配;逃逸对象,在堆上分配。

Go 依赖管理演进

Go 语言中,依赖管理的演进分为三个阶段,依次是:

  • GOPATH
  • Go Vendor
  • Go Module

GOPATH

配置环境变量 $GOPATH,GOPATH 下有以下三个文件夹:

  • bin:项目编译的二进制文件
  • pkg:项目编译的中间产物,用于加速编译
  • src:项目源码

项目的代码直接依赖于 src 下的代码,可以通过 go get 命令将依赖包下载到 src 下。


GOPATH 的缺点在于:无法实现对 package 的多版本控制。

若 A 和 B 依赖于某一 package 的不同版本,这样的情况 GOPATH 无法解决。

Go Vendor

项目目录下增加 vendor 文件夹,所有依赖包的副本存放在项目下的 vendor 文件夹中。

若 vendor 中没有依赖包,则会在 GOPATH 下去寻找。


Go Vendor 的缺点在于:无法控制依赖的版本、更新项目可能出现依赖冲突。

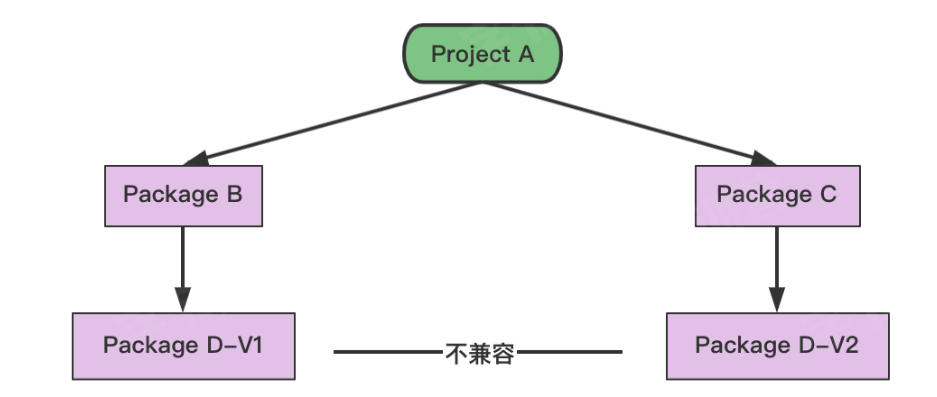
若一个项目依赖于 package B 和 packag C,而 package B 依赖于 package D-V1 版本;package C 依赖于 package D-V2 版本。这样的场景下,Go Vendor 无法很好的解决。
1655220603232

Go Module

Go Module 通过 go.mod 文件管理依赖包版本。

通过 go get / go mod 工具,管理依赖包。

Go Module 详解

依赖管理三要素

Go Module 中,依赖管理需要三要素:

  • go.mod:配置文件,描述依赖。
  • Proxy:中心仓库管理依赖库。
  • go get/mod:本地工具。

go.mod

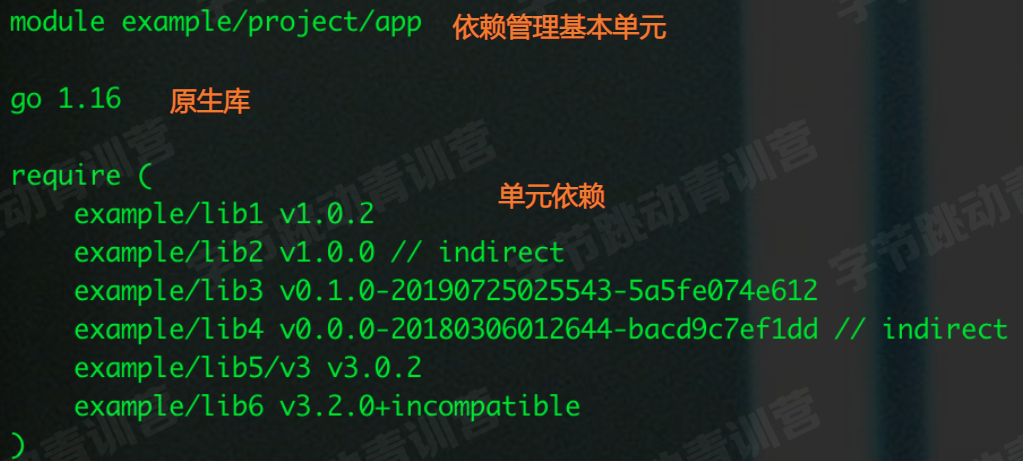
go.mod 文件主要由三部分构成:

  • 依赖管理基本单元:标识了这个模块可以在哪里找到(被其他人引用)。
  • 原生库:Go 的版本号。
  • 单元依赖:描述依赖关系,主要两部分组成。
    • 包名(Module Path)
    • 版本号

1655220918315

其中,可以看到单元依赖的一些配置:

  • version:
    • 语义化版本:${MAJOR}.${MINOR}.${PATCH},MAJOR 是一个大版本,不同 MAJOR 可以不兼容。MINOR 做出了一些新增函数,同一个 MAJOR 下需要相互兼容。PATCH 做了一些 bug 修复。
    • 基于 commit 伪版本:vx.0.0-yyyymmddhhmmss-abcdefgh1234。
  • indirect:对于没有直接依赖的 package,就用 indirect 标识出来。
  • incompatible:如果 MAJOR 版本大于 1 时,其版本号还需要体现在 Module 名字中(如 xxx/xx/v2)。但是如果 Module 名字未遵循这条规则,则会打上 incompatible 标记。

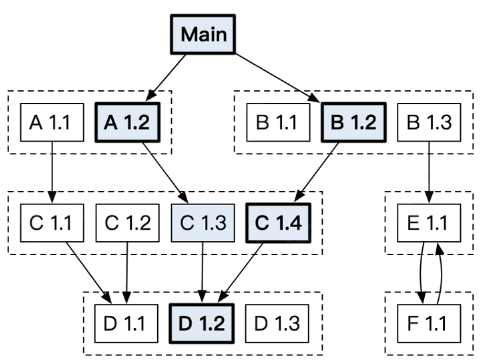
Go 在选择版本时,会选择最低的兼容版本:

如下图中,最终编译时所使用的 C 项目版本为 1.4 版本。
1655221776213

Proxy

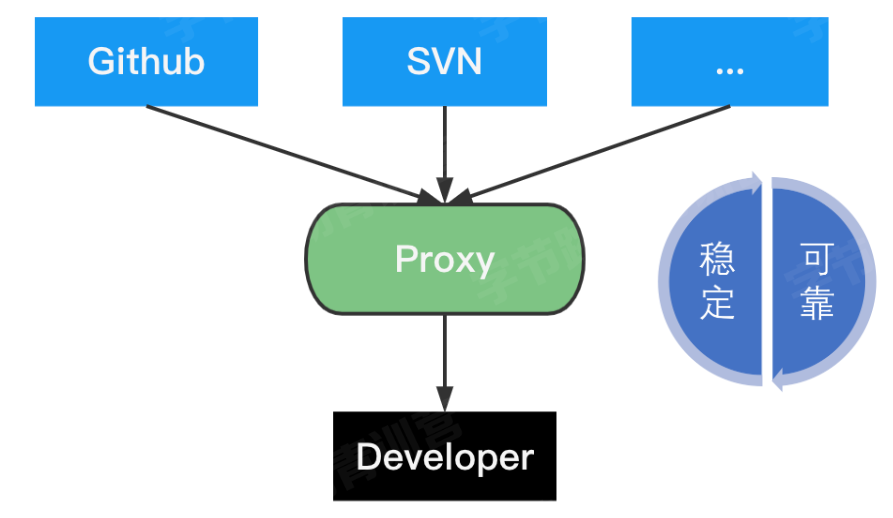
Go Proxy 是一个服务站点,他会缓存源站中的软件内容,缓存的软件版本不会改变,源站软件删除后依然可用。
1655221901310

GOPROXY="https://proxy1.cn,https://proxy2.cn,direct",含义是依次从 proxy1、proxy2、源站中获取 package。

go get/mod

  • go get:go get example.org/pkg,参数如下:

    • @update:默认,获取最新版本。
    • @none:删除依赖。
    • @v1.1.1:语义化版本。
    • @45dfsf:特定的 commit。
    • @master:分支的最新 commit。
  • go mod:参数如下:

    • init:初始化,创建 go.mod 文件。
    • download:下载模块到本地。
    • tidy:增加需要的依赖,删除不需要的依赖。

BERT 介绍

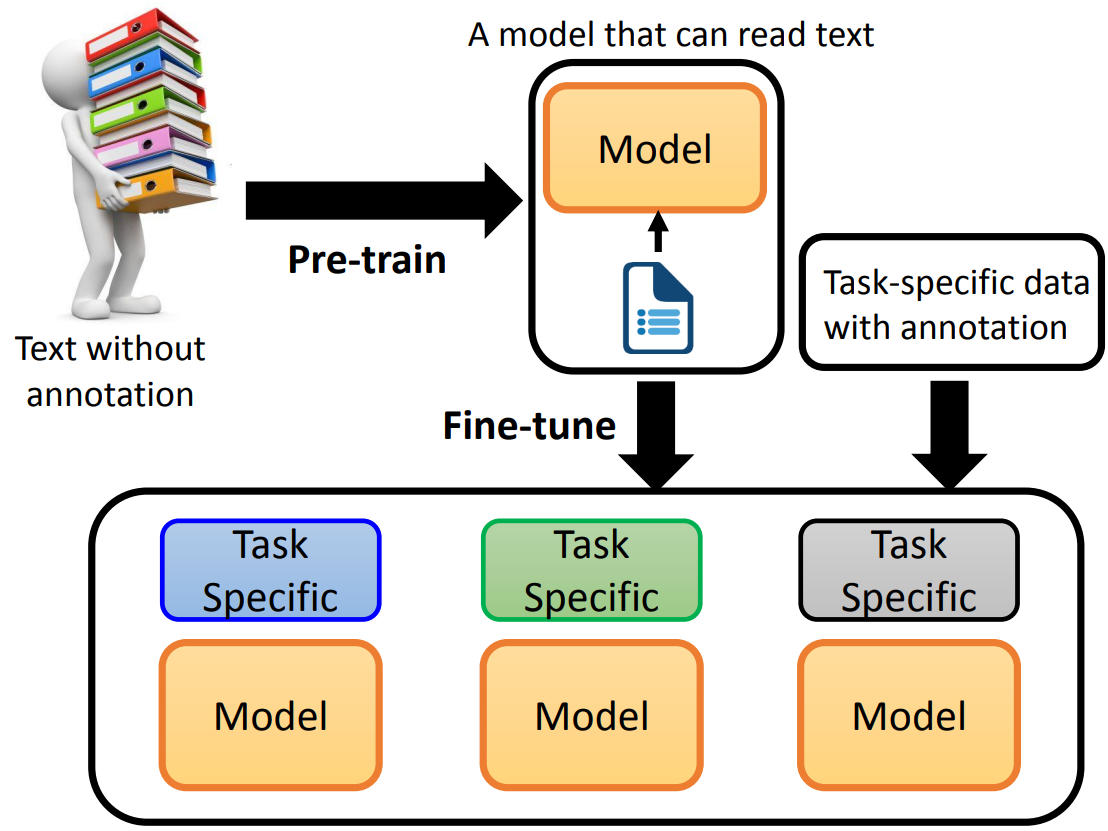
我们将一些不带标注的文章,先预训练,得到一个 Model,这个 Model 可以看作是能够理解文字内容。

接着用一些带标注的特殊语料,进行 Fine-tune(微调),训练出可以完成特殊任务的 Model。

1654002682379

阅读全文 »

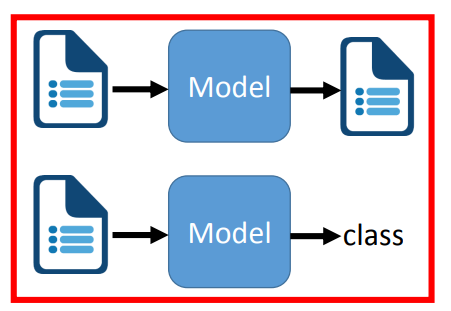
NLP 任务分类

NLP 任务总的来说分为两类:

  • 输入文字,输出类别。
  • 输入文字,输出另一段文字。

1653914138938

那么进一步的,可以根据输入和输出的不同,进行划分。

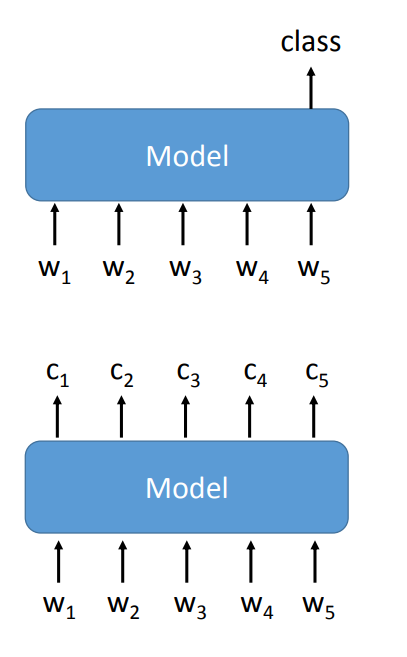
输出的不同

  • 输出类别:
    • 为一段话,只输出一个类别。
    • 为每一个 token 都输出一个类别。

1653914425983

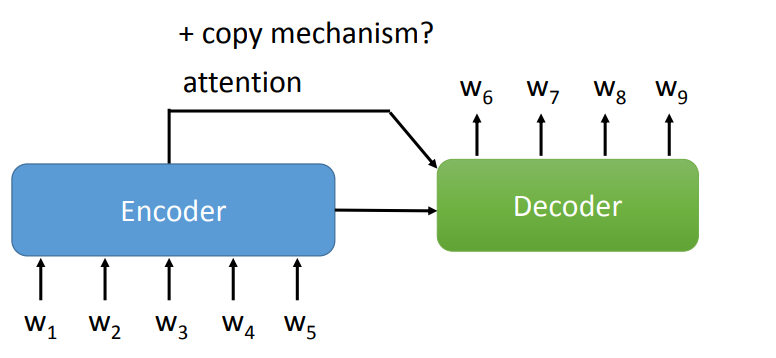
  • 输出另一段文字:
    • 使用 seq2seq 模型。

1653914435623

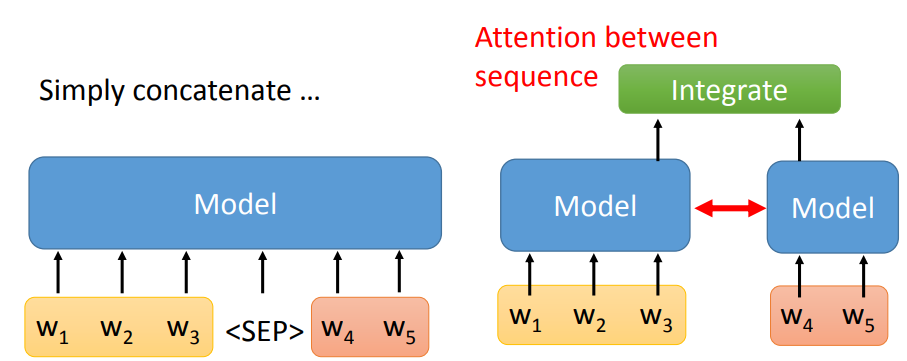
输入的不同

  • 一段文字。
  • 多段文字:
    • 将多段文字拼接起来,中间用 <SEP> 连接。
    • 分别放入 Model 中,再对输出进行整合。

1653914566952

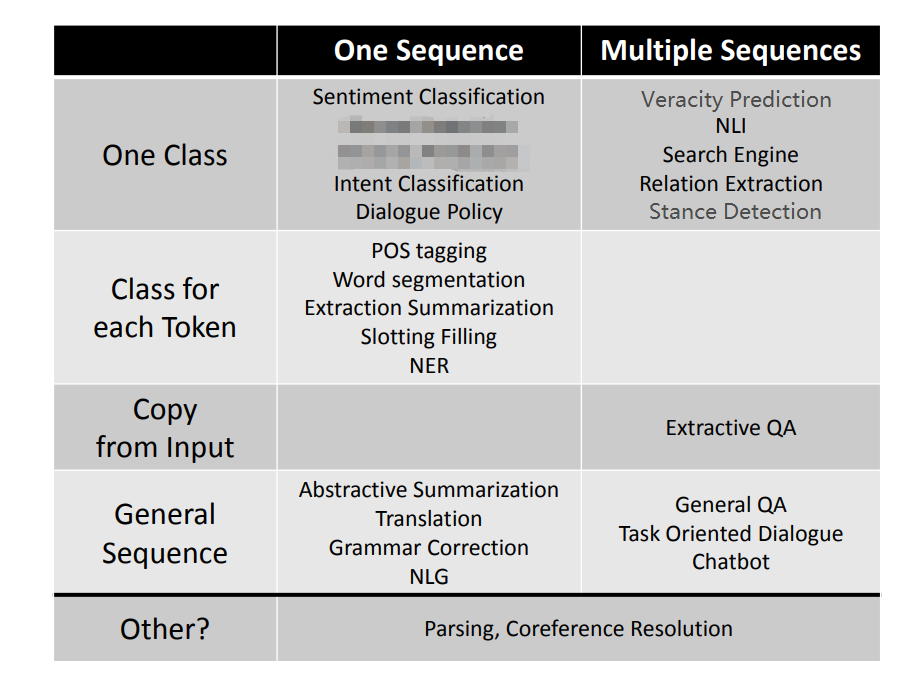
NLP 任务

1653916977054

知识图谱

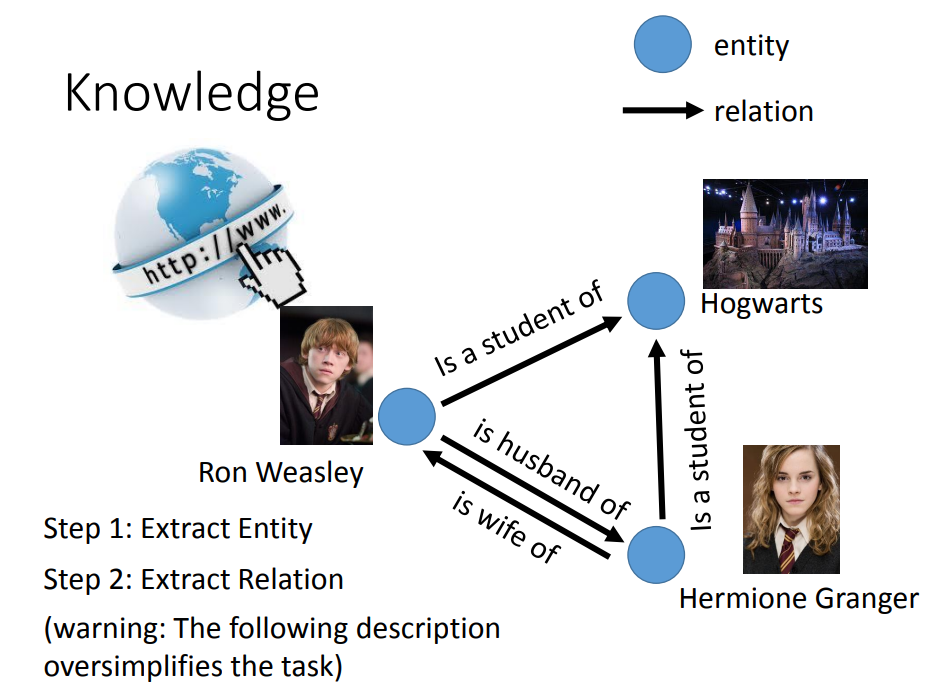
知识图谱中,最重要的就是实体(Entity)和关系(Relation)。

1653917666204

提取实体 - NER

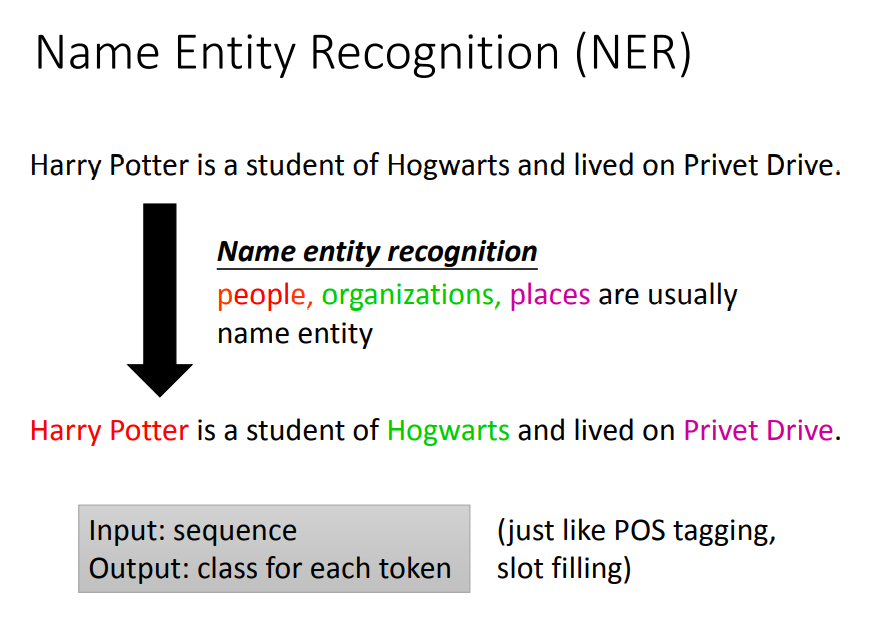
NER,Name Entity Recognition,命名实体识别。用于提取一段文字中给定的实体信息。
1653917699539

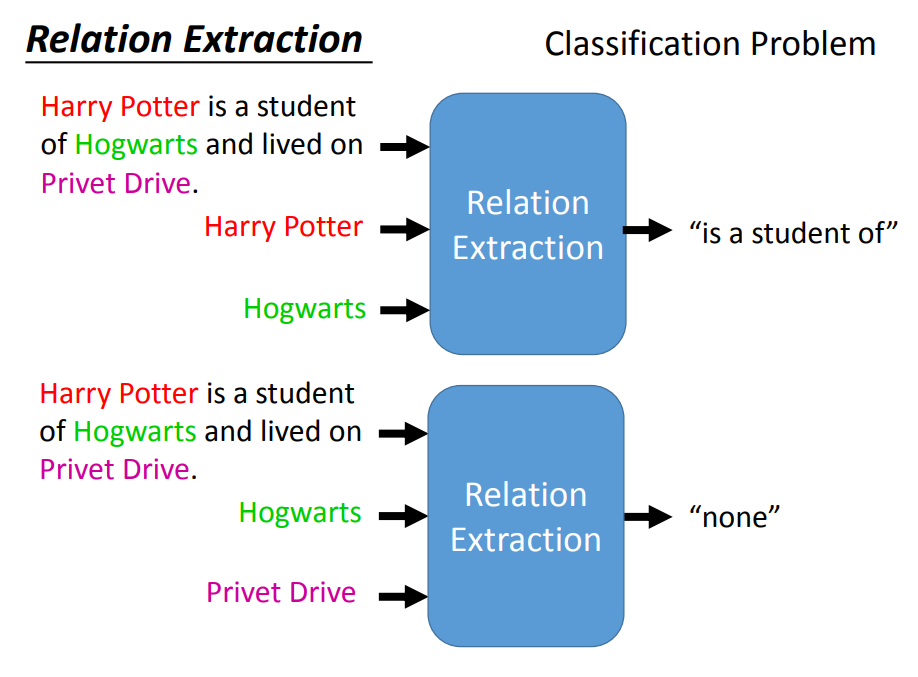
提取关系

提取关系,可以看成是一种分类问题。

1653917789907